目次
「5,000文字書けば上位」という目安に、根拠はあるのか
「このキーワードは競合が長いから、最低5,000文字で書いて」。SEO記事の発注や編集の現場で、いまも普通に飛び交う指示です。文字数の下限を決めると管理はしやすくなります。ただ、その数字の出どころをたどると、たいていは「上位記事がそのくらいだったから」に行き着きます。上位が長いから自分も長く書く、という逆算です。ここで一度立ち止まる価値があります。文字数を増やすこと自体が順位を押し上げるのか、それとも長さは別の何かの副産物なのか。この問いに答えないまま数字を追うと、水増しされた読みにくい記事を量産することになります。まず、検索エンジンが文字数をどう扱っているのかを、発言元まで遡って確認します。
Googleは文字数を順位要因にしていない
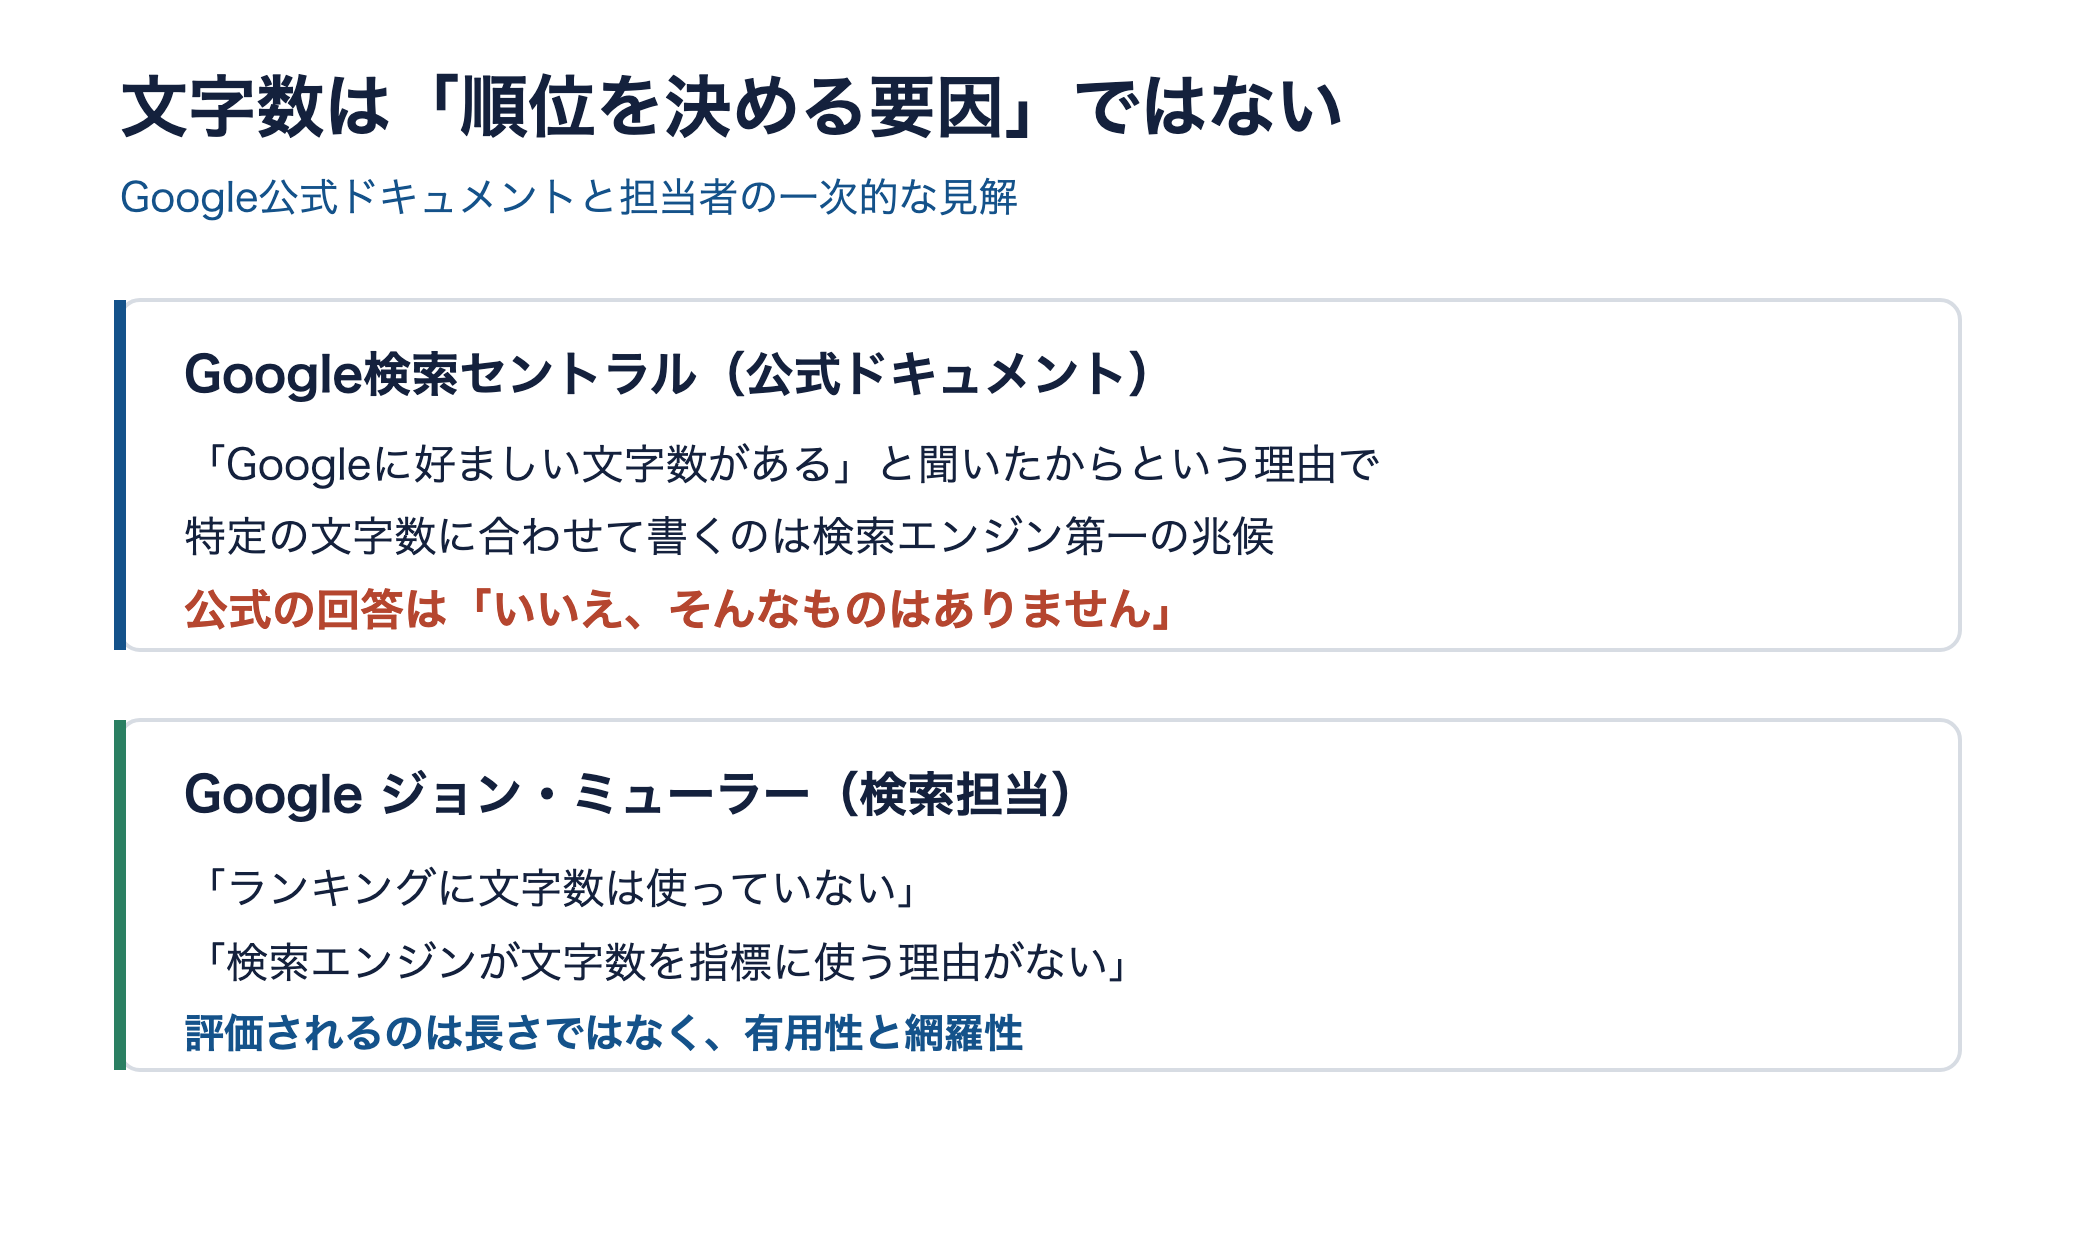
結論から書きます。Googleは、特定の文字数を推奨していません。有用なコンテンツの作り方をまとめた公式ドキュメントには、避けるべき「検索エンジン第一」の姿勢を自己点検する項目が並び、その一つに文字数への言及があります。要約すると「Googleに好ましい文字数があると聞いた、あるいは読んだから、という理由で特定の文字数に合わせて書いていないか」という問いで、そこに添えられた公式の答えが「いいえ、そんなものはありません」です。つまりGoogle自身が、目標文字数に合わせて書く行為を、ユーザーではなく検索エンジンに向けた書き方だと名指ししています。文字数という数字は、評価の入口にすら置かれていません。
検索担当のジョン・ミューラーも、同じことを繰り返し述べてきました。2020年の一連の発信では「ランキングに文字数は使っていない」「そもそも検索エンジンが文字数を指標に使う理由がない」と明言しています(Search Engine Journal によるMueller発言の報道)。彼は別の場でも、文字数の多寡でコンテンツの薄さを判定するアルゴリズムは存在しないと説明しました。ここが分かれ目です。文字数を増やせば機械的に加点される、という前提そのものが成り立ちません。評価されるのはページ全体が読み手の課題をどれだけ解決しているかであり、その中身が伴えば長さは問われない、というのが一貫した立場です。
実務に引き寄せると、この立場は二つのことを意味します。一つ目は、短いページが長いページに順位で負ける必然はない、ということ。検索意図に一撃で答える簡潔なページが、冗長な長文を上回る場面は珍しくありません。二つ目は、上位の長い記事を「長さ」の面だけ真似ても届かない、ということです。競合が5,000字だから自分も5,000字、という発想は、順位を動かす本体である中身の設計を素通りしています。文字数は結果を映す鏡ではあっても、結果を作るレバーではない。この区別を最初に握っておくと、以降の判断がぶれません。
それでも「目安◯◯文字」が広まり続ける理由
公式が否定しているのに、なぜ「3,000字」「5,000字」という目安が消えないのか。理由は単純で、その数字が便利だからです。発注者は品質を測る物差しがほしい。ライターは分量の見当をつけたい。編集者は薄い原稿を突き返す口実がほしい。文字数は誰の目にも見える唯一の共通指標なので、本来の「網羅性」や「有用性」の代わりに使われてきました。数えられるものが、数えにくいものの身代わりになる構図です。管理コストの低さが、根拠の弱さを上回って生き残っているわけです。
もう一つの理由は、目安の数字がたいてい「上位記事の平均文字数」から作られている点にあります。上位を調べて平均を取れば、それらしい数字は必ず出ます。問題は、その平均を「上位に入るための条件」と読み替えてしまうことです。平均は現状の描写であって、原因の証明ではありません。この読み替えが、文字数神話の温床になっています。数字を出すこと自体は悪くありません。危ういのは、その数字を目標として頭に固定し、中身の設計より先に分量を埋めにいく順番のほうです。
この誤解が根強いのは、過去に一部のツールや情報源が「長文ほど有利」という単純な図式を広めた歴史も関係しています。かつては薄い記事が乱立していた時代があり、その反動で「しっかり書く=長く書く」という等式が浸透しました。長く書くこと自体は、網羅性を追う過程としては健全です。問題は、その等式が独り歩きし、中身を伴わない長さまで正当化してしまった点にあります。いま必要なのは等式の更新です。「しっかり書く」の中身を、長さではなく、読み手の問いにどれだけ答えたかで測り直す。ここを切り替えないと、古い神話のまま新しい記事を量産し続けることになります。
なぜ上位記事は長く見えるのか|相関≠因果を1,447語の平均で読み解く
「でも実際に上位を見ると長い記事ばかりだ」という反論はもっともです。体感は正しい。長い記事は確かに上位に多い。ただ、その事実から「長いから上位」と結論づけるのは、相関を因果に取り違える典型的な誤りです。ここを大規模なデータで確かめると、文字数神話の正体がはっきりします。
相関と因果の違いは、言葉にすると当たり前でも、日々の判断では驚くほど混同されます。二つの事柄が一緒に増減しているのが相関、片方がもう片方を引き起こすのが因果です。上位記事が長いという観察は相関にすぎず、そこから長さが順位を引き起こすという因果を導くには、別の証拠が要ります。その証拠を探しに行った大規模調査が、むしろ「直接の相関すら弱い」という結果を返してきました。ここを押さえると、目安の数字を見る目つきが変わります。
11.8M件調査の「平均1,447語」が独り歩きする
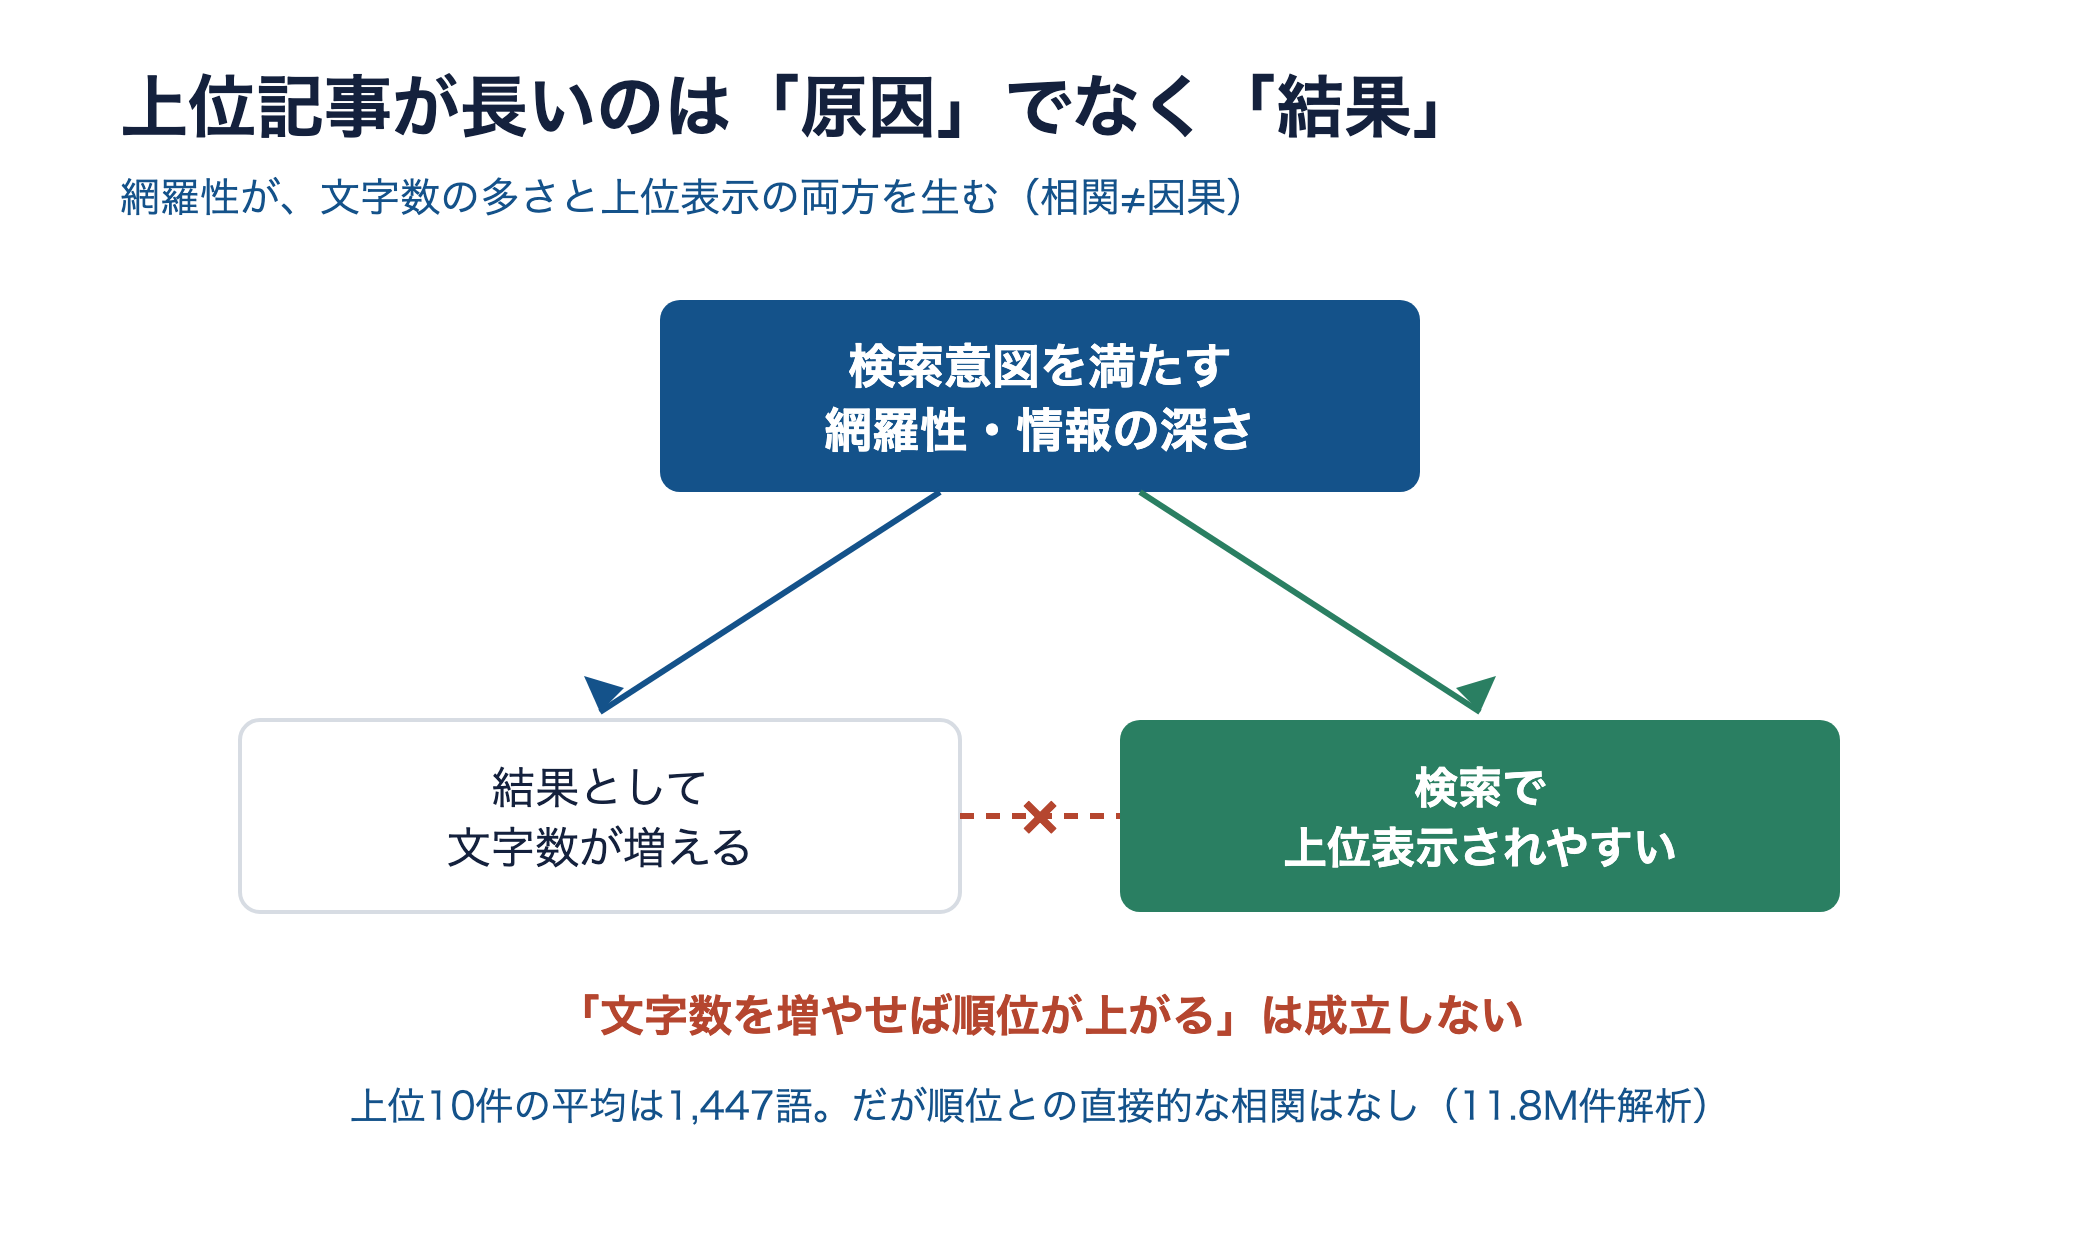
よく引用される数字があります。Google検索1ページ目に入った結果の平均は1,447語。これはBacklinkoが1,180万件の検索結果を解析した調査の値です。この「1,447」という数字だけが独り歩きし、「だいたい1,500語前後を狙えばいい」という目安に化けてきました。ところが同じ調査は、もう一歩踏み込んだ結論を出しています。上位10件の中で文字数はほぼ均等に分布しており、順位と文字数の間に直接的な相関は見られなかった、というものです。1位が最も長く10位が最も短い、といった並びにはなっていません。平均は「1ページ目に届いた記事群の平均像」であって、「上位ほど長い」を意味しないわけです。
この違いは決定的です。平均1,447語という一点を目標に据えると、短くても十分な検索意図に対して無理に文字を足すことになります。逆に、本来2倍の情報量が必要なテーマを平均値で早じまいすることもあります。同じ調査は、記事の長さが直接順位を上げるのではなく、長い記事が被リンクを集めやすいといった間接的な経路を示唆しました。長さは順位の原因ではなく、他の要因と一緒に動く相関の一部にすぎません。数字を借りるなら、平均値ではなく、その調査が本当に言っている「文字数は順位と直結しない」という結論のほうです。
身近な例で考えると分かりやすくなります。同じキーワードで1位と8位を並べて読むと、1位のほうが短いことは普通に起きます。1位が短くても勝てるのは、読み手の一番知りたい点に最短で答え、余計な回り道がないからです。逆に、下位の長い記事は、関連キーワードを詰め込んだ結果として文字数だけがふくらみ、肝心の問いへの答えがぼやけていることがあります。文字数の順序と順位の順序は、そもそも一致しません。平均という一つの数字を見て「長いほど強い」と思い込むと、この目の前の反例が見えなくなります。
長さは原因ではなく、検索意図を満たした結果
では、なぜ上位記事は長くなりがちなのか。答えは順序を逆に見ると通ります。あるキーワードで検索する人が知りたいことを、漏れなく、かつ深く説明しようとする。すると扱うべき論点が増え、具体例や手順や注意点が積み上がり、結果として文字数が伸びる。長さは「網羅性を追った副産物」です。そして同じ網羅性が、検索意図を満たすページとしてGoogleにも評価され、上位に入りやすくなる。つまり網羅性という一つの原因が、文字数の多さと上位表示の両方を同時に生んでいます。文字数と順位が並んで見えるのは、この共通の原因を挟んでいるからです。
この構造が分かると、打ち手が変わります。上位記事の文字数に合わせて水増ししても、原因である網羅性は増えないため、順位は動きません。ミューラーの言葉を借りれば、上位記事と同じ文字数にそろえたところでページが一緒に1位になるわけではない、ということです。狙うべきは長さそのものではなく、その長さを生んでいる中身の充実です。文字数を目的にすると結果が出ず、網羅性を目的にすると文字数は後からついてくる。順番の問題として捉え直すと、やることは驚くほどシンプルになります。
相関を因果と取り違える誤りは、SEOの外にもあふれています。アイスが売れる日は水難事故も増えますが、アイスが事故を起こすわけではなく、猛暑という共通の原因が両方を押し上げているだけです。文字数と順位の関係もこれと同じ形をしています。網羅性という猛暑が、文字数というアイスと、上位表示という事故を同時に増やす。だから文字数だけを操作しても順位は動かない。この比喩を頭の片隅に置いておくと、「上位が長いから長く書く」という反射的な発想に、自分でブレーキをかけられます。
文字数ではなく網羅性で勝つ記事は、競合の論点を洗い出す設計から始まります。激安AI SEOは、検索意図の分解と競合の網羅分析を工程に組み込み、必要な情報量から逆算して記事を組み立てます。
本当の「目安」の出し方|競合の情報網羅性から必要量を逆算する
文字数が原因でないなら、目安は不要かというと、そうではありません。分量の見当は、進行管理にも見積もりにも要ります。ただし出し方の順番を変えます。数字を先に決めて中身を合わせるのではなく、満たすべき中身を先に決めて、その結果として分量を見積もる。文字数ありきから、網羅性ありきへ。この逆算のやり方を、具体的な手順に落とします。
文字数ありきをやめ、検索意図の構成要素を洗い出す
最初にやるのは、キーワードの背後にある問いを分解することです。たとえば「SEO 文字数」で検索する人は、単に何文字が正解かを知りたいだけではありません。文字数が本当に順位に効くのか、少ない文字数で上位を取れるのか、水増しで罰を受けないか、といった複数の不安を抱えています。これらを「知りたい・比べたい・今すぐ決めたい」の層に分けて並べると、記事が答えるべき問いのリストができます。このリストが、記事の骨格であり、必要な情報量の源です。文字数を決めるより先に、この問いの数と深さを見積もることが、逆算の出発点になります。
ここで効くのは、実際に検索して上位に並ぶ記事を読み、彼らが答えている問いと、答えきれていない問いを仕分けることです。EXIDEAがBtoB企業106社に行った調査では、記事制作で成功した企業が決め手に挙げたのは価格でも分量でもなく「コンテンツ1本1本の質」で、35.8%が最上位に選んでいます(EXIDEA調査 2022年4月 n=106)。質とは、読み手の問いにどれだけ正面から答えているかです。問いを洗い出す作業は、その質を設計する作業とほぼ同義になります。
洗い出した問いは、優先順位をつけて並べ替えると設計図として使えます。検索した瞬間に最も解消したい不安を先頭に置き、その後に比較や具体手順を続ける。この並びが決まれば、見出しの骨格はほぼ完成し、各見出しに割く分量の見当も自然につきます。ここで文字数を先に固定していないことが効いてきます。問いの重要度に応じて厚く書く場所と、簡潔に済ませる場所を配分できるからです。全体を一律の分量で埋める発想を捨てると、読み手にとっての濃淡が生まれ、同じ総文字数でも体感の密度がまるで変わります。
競合上位の網羅トピックから必要量を逆算する4手順
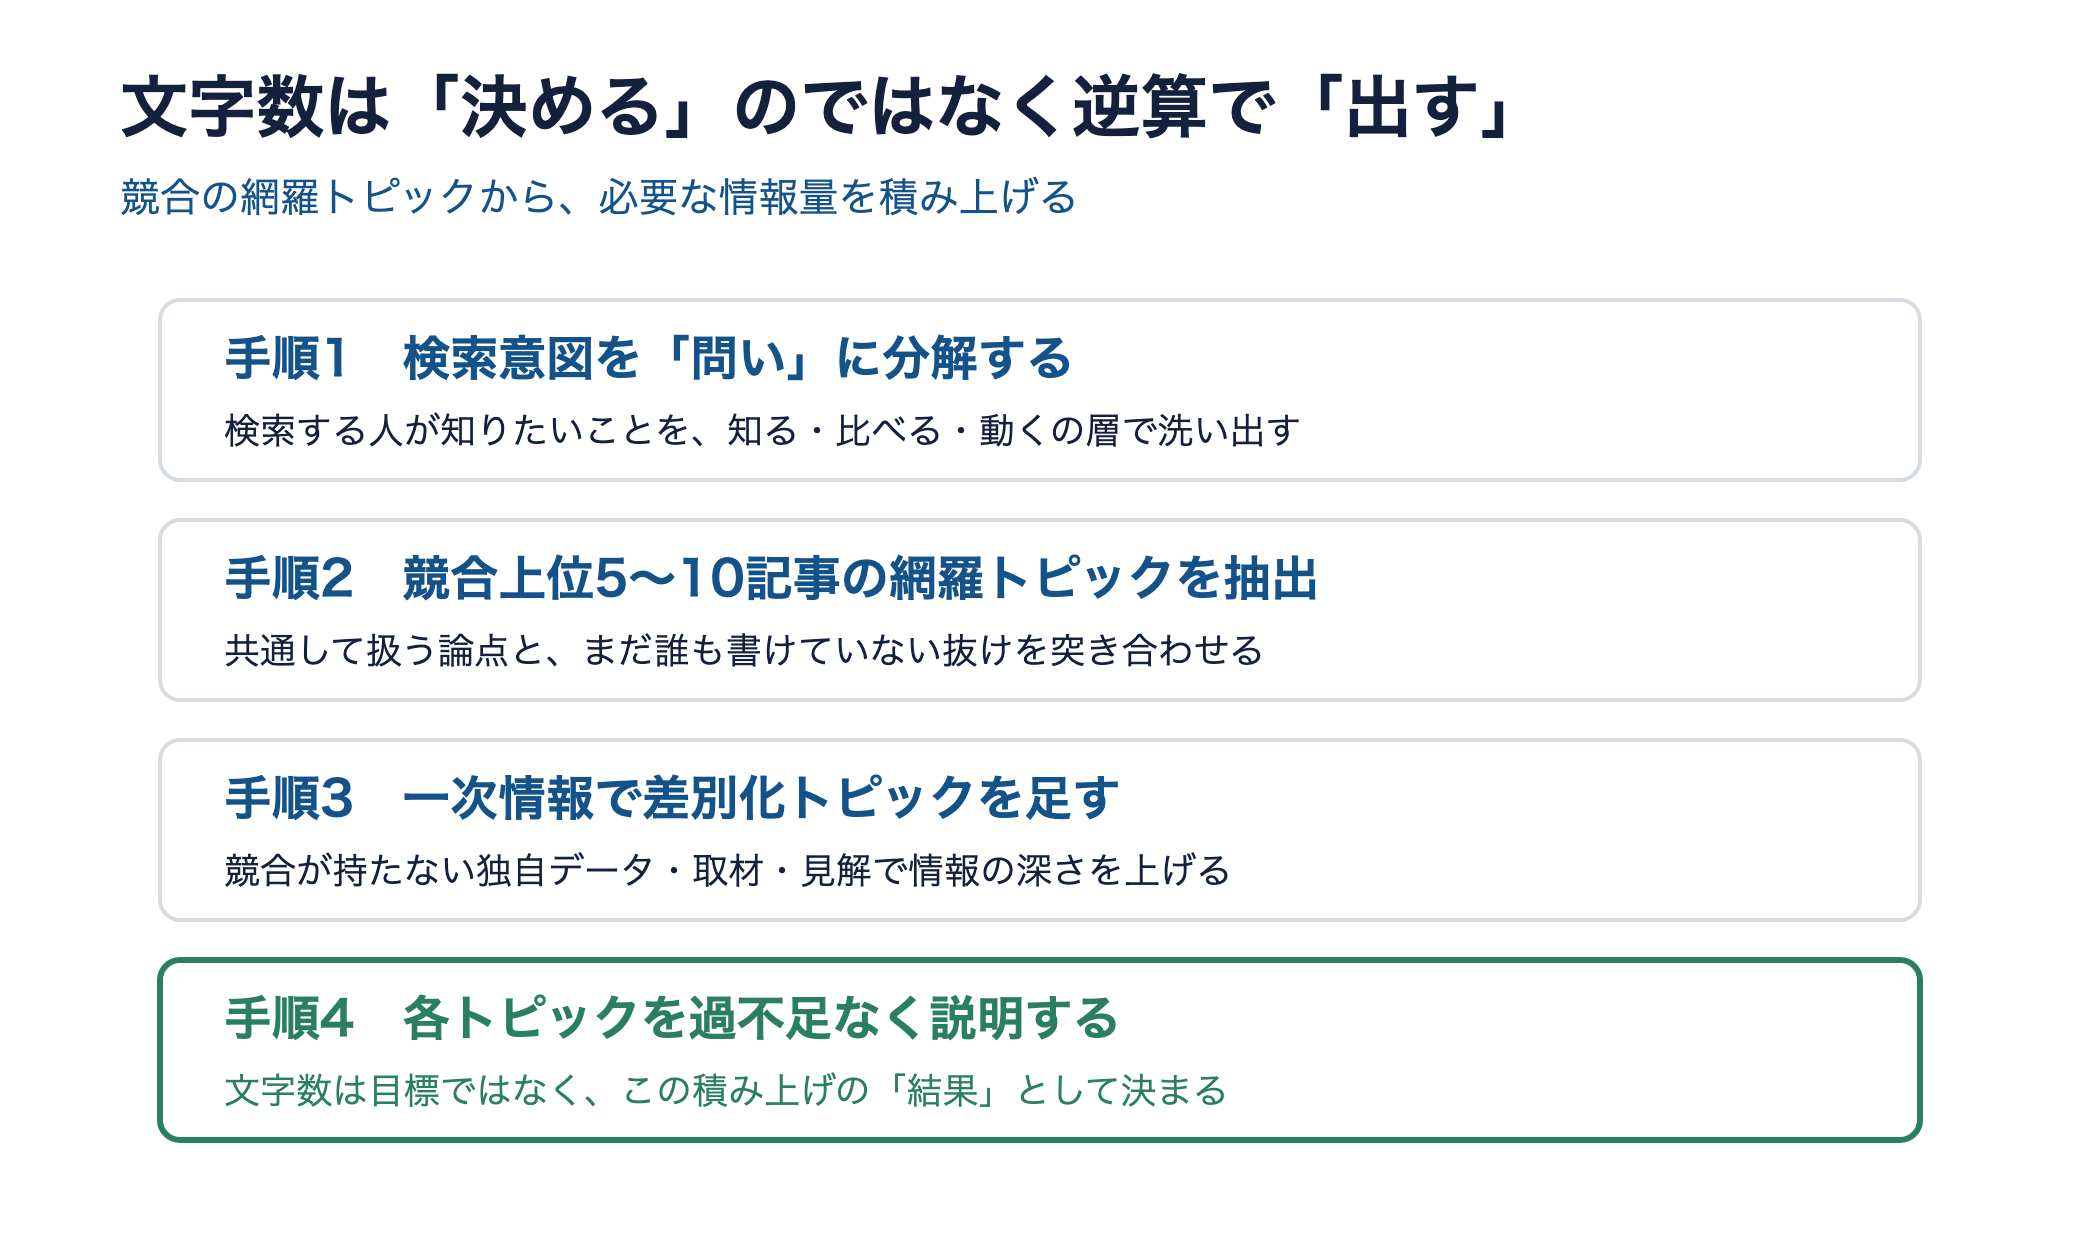
逆算は4つの手順に分けると回しやすくなります。問いを分解し、競合が扱う網羅トピックを抜き出し、自社の一次情報で差をつけるトピックを足し、最後にそれぞれを過不足なく説明する。この積み上げの合計が、そのキーワードで必要な情報量になります。文字数は最後に出てくる数字であって、最初に置く目標ではありません。
| 手順 | やること | 出力 |
|---|---|---|
| 1 検索意図の分解 | 検索する人の問いを、知る・比べる・決めるの層で洗い出す | 答えるべき問いのリスト |
| 2 競合の網羅トピック抽出 | 上位5〜10記事の見出しと論点を突き合わせる | 共通トピックと抜けトピック |
| 3 差別化トピックの追加 | 一次情報・独自見解で競合にない要素を足す | 最終トピックセット |
| 4 必要量の見積り | 各トピックを過不足なく説明する分量を積み上げる | 結果としての文字数レンジ |
この手順の肝は、手順3にあります。競合の網羅トピックをなぞるだけなら、出来上がるのは上位記事の焼き直しで、長くはなっても差はつきません。自社の一次情報、たとえば実測データ、取材で得た現場の声、独自の分類軸を足して初めて、同じ長さでも読む価値が変わります。Googleが制作の手段や量ではなく有用性で評価すると明言している以上、差がつくのはこの独自性の部分です(Google 検索セントラル Google検索とAIコンテンツ)。逆算で出した分量は、あくまで見積もりの初期値です。書き進めて過不足が見えたら調整すればよく、最初の数字に縛られる必要はありません。
競合の網羅トピックの抽出と、一次情報での差別化は手間のかかる工程です。激安AI SEOは、この逆算のプロセスをAIで高速化しつつ人手で検証し、水増しに頼らない濃い記事を低コストで仕上げます。
薄い水増しと過剰な長文|文字数を目的化した記事が沈む理由
文字数を目標に据えると、二方向の失敗が待っています。一つは、目標に届かせるための水増し。もう一つは、長ければ安心という思い込みからくる過剰な長文です。どちらも「数字を満たす」ことが目的になった瞬間に生まれます。それぞれ、なぜ順位につながらないのかを見ます。
目標文字数に合わせた水増しがGoogleに嫌われる仕組み
目標が「5,000文字」になると、書き手は無意識に文字を稼ぎにいきます。同じ内容を言い換えて繰り返す、前置きを長くする、検索意図と関係ない周辺情報を足す。こうした水増しは、読み手の課題解決には一切寄与しません。むしろ、答えにたどり着くまでの距離を伸ばし、離脱を招きます。Googleが公式に「特定の文字数に合わせて書く」ことを検索エンジン第一の兆候として挙げているのは、まさにこの構図を問題視しているからです。数字を満たすための加筆は、ユーザーではなくアルゴリズムを意識した書き方であり、有用性の評価では逆風になります。
水増しの厄介なところは、書いた本人には仕事をした感覚が残る点です。文字数は増え、原稿は分厚くなる。達成感はある。けれど、読み手が知りたかった一点への答えは薄まっています。品質を文字数で測る限り、この錯覚からは抜けられません。測る対象を「問いにいくつ、どれだけ深く答えたか」に変えると、水増しは即座に無駄な作業として見えてきます。分量ではなく解決量で自分の原稿を採点する習慣が、水増しへの最良の予防になります。
水増しには、読めば分かる典型的なサインがあります。同じ主張が言い回しを変えて何度も出てくる。一般論の前置きが長く、具体に入るまでが遠い。検索意図と関係の薄い豆知識が挿し込まれている。書き上げた原稿を見直すとき、各段落に「この段落は読者のどの問いに答えているか」を一言で付けられるか試すと、答えられない段落が水増しの候補です。そこを削っても情報は減りません。むしろ答えまでの距離が縮まり、読み手の満足度は上がります。文字数が減ることを損失と感じるうちは、まだ数字に縛られている証拠です。
「長ければ安心」という逆方向の失敗
逆の失敗もあります。文字数が順位と無関係だと知った上で、なお「短いと不安だから長くしておこう」と考えるケースです。網羅性を追った結果として長くなるのは健全ですが、不安を埋めるために長くするのは、動機が水増しと変わりません。とくに行動誘導型の検索、たとえば「近くの店」「申し込み方法」のように答えが短くて済む意図に対して長文をぶつけると、読み手は必要な情報を探して迷い、かえって満足度が下がります。短く即答することが最適解になる場面は、想像より多くあります。
長文には見えにくいコストもあります。制作時間が延び、更新の負担が増え、情報が古びたときの修正範囲も広がる。かけた工数に対して、順位という見返りは長さに比例しません。総務省の令和7年版情報通信白書では、生成AIの活用方針を定める企業が49.7%まで伸び、記事制作の高速化が進んでいます(総務省 令和7年版情報通信白書)。速く大量に書ける時代だからこそ、長さで安心を買う発想は割に合いません。必要な分だけ書き、そこに独自性を凝縮するほうが、制作の効率でも成果でも勝ります。
検索意図タイプ別の文字数レンジ|数字を持つなら「自分用の物差し」として
ここまで文字数を目標にするなと書いてきましたが、数字を完全に捨てる必要はありません。見積もりや進行管理のための「自分用の目安」としてなら、レンジを持っておくと便利です。大切なのは、それを順位の条件ではなく、逆算の初期値として扱うことです。検索意図のタイプ別に、実務でよく使われるレンジ感を整理します。
レンジを持つ利点は、逆算した必要量が妥当かを素早く点検できることにあります。手順どおりにトピックを積み上げて8,000字になったとき、その意図タイプの相場から大きく離れていれば、どこかで論点を盛りすぎたか、逆に相場より短ければ抜けがあるかもしれない、と当たりをつけられます。レンジは答えではなく、問い直しのきっかけです。数字が先にあるのではなく、逆算の結果を検算するために数字を後ろに置く。この主従関係さえ崩さなければ、目安は文字数神話とは別物の、健全な管理ツールとして機能します。
情報網羅型・比較検討型・行動誘導型のレンジ感
| 意図タイプ | 読者の状態 | レンジの目安 | 注意点 |
|---|---|---|---|
| 情報網羅型(〜とは・やり方) | 体系的に理解したい | 3,000〜6,000字 | 網羅性の結果であって目標ではない |
| 比較検討型(比較・おすすめ) | 選択肢を絞りたい | 2,000〜4,000字 | 比較軸の数で伸縮する |
| 行動誘導型(申込・購入・近く) | 今すぐ動きたい | 800〜1,500字 | 短く即答が有利な場合が多い |
このレンジは、あくまで実務の経験則で、絶対の基準ではありません。情報網羅型でも、答えが一つに定まる素朴な疑問なら1,000字で足りることがあります。逆に比較検討型でも、比較軸が多く判断材料が厚いテーマなら6,000字を超えて自然です。表の数字を「これ以上書かないと危ない」と読むと、また文字数神話に逆戻りします。読み方は逆で、逆算した必要量がレンジから大きく外れたとき、なぜ外れたのかを点検するためのチェックポイントとして使います。極端に短ければ論点の抜けを、極端に長ければ水増しを疑う、という具合です。
タイプの境界も、実際には地続きです。「SEO 文字数」というキーワード一つとっても、定義を知りたい情報網羅型の顔と、他社サービスと比べたい比較検討型の顔が混ざります。検索結果に並ぶ記事の型を観察し、上位がどのタイプに寄っているかを見て、自分の記事の重心を決めると精度が上がります。レンジ表はその重心を仮置きするための出発点であり、検索結果を見ながら上下に調整する前提の数字です。数字を固定値ではなく可変の初期値として扱う。この一点さえ守れば、レンジは神話に戻らず、実務の役に立つ道具のままでいてくれます。
Muellerも認める「自分用ガイドライン」としての使い方
ミューラー自身、文字数の数字を全否定しているわけではありません。ランキングには使われないと断った上で、社内で書き手により良い原稿を促すためのガイドラインとして文字数を使うのは問題ない、という趣旨も述べています。要は、対Googleの武器としてではなく、対自分たちの品質管理ツールとして使うなら理にかなう、ということです。編集部で「この種の記事はだいたいこのくらいの情報量が必要」という共通認識を持てば、原稿のばらつきは減ります。数字そのものが悪なのではなく、数字を順位の因果と取り違える使い方が失敗を生みます。
やることは3つに絞れます。文字数を順位の条件だと思うのをやめる。競合の網羅トピックと自社の一次情報から必要量を逆算する。出てきた数字は、順位の保証ではなく進行管理と品質点検の物差しとして扱う。次に記事を書くときは、目標文字数を決める前に、答えるべき問いを紙に書き出すところから始めてみると、分量は自ずと見えてきます。文字数を追いかけるのをやめた瞬間に、記事の中身は濃くなります。
文字数ではなく網羅性と一次情報で勝つ記事を、低コストで量産したい。激安AI SEOは、検索意図の逆算設計から人手のファクトチェックまでを標準工程にし、水増しに逃げない記事づくりを支援します。まずは無料で相談できます。