目次
ChatGPTが情報源を選ぶ2つの経路|Web検索と学習データで打ち手が変わる
「ChatGPTに引用されるには」を調べると、FAQを付ける、結論を先に書く、といった施策リストがすぐ出てきます。ただ、施策を並べる前に押さえたいのは、ChatGPTがそもそもどこから情報を引いてくるかです。回答の下に出典リンクが並ぶ経路と、リンクが出ない経路では、効かせるべき施策が違います。ChatGPTが情報にたどり着く道は大きく2つ。1つはリアルタイムのWeb検索、もう1つは事前学習した知識です。この2経路を分けて考えると、闇雲にFAQを足すより先にやるべきことが見えてきます。
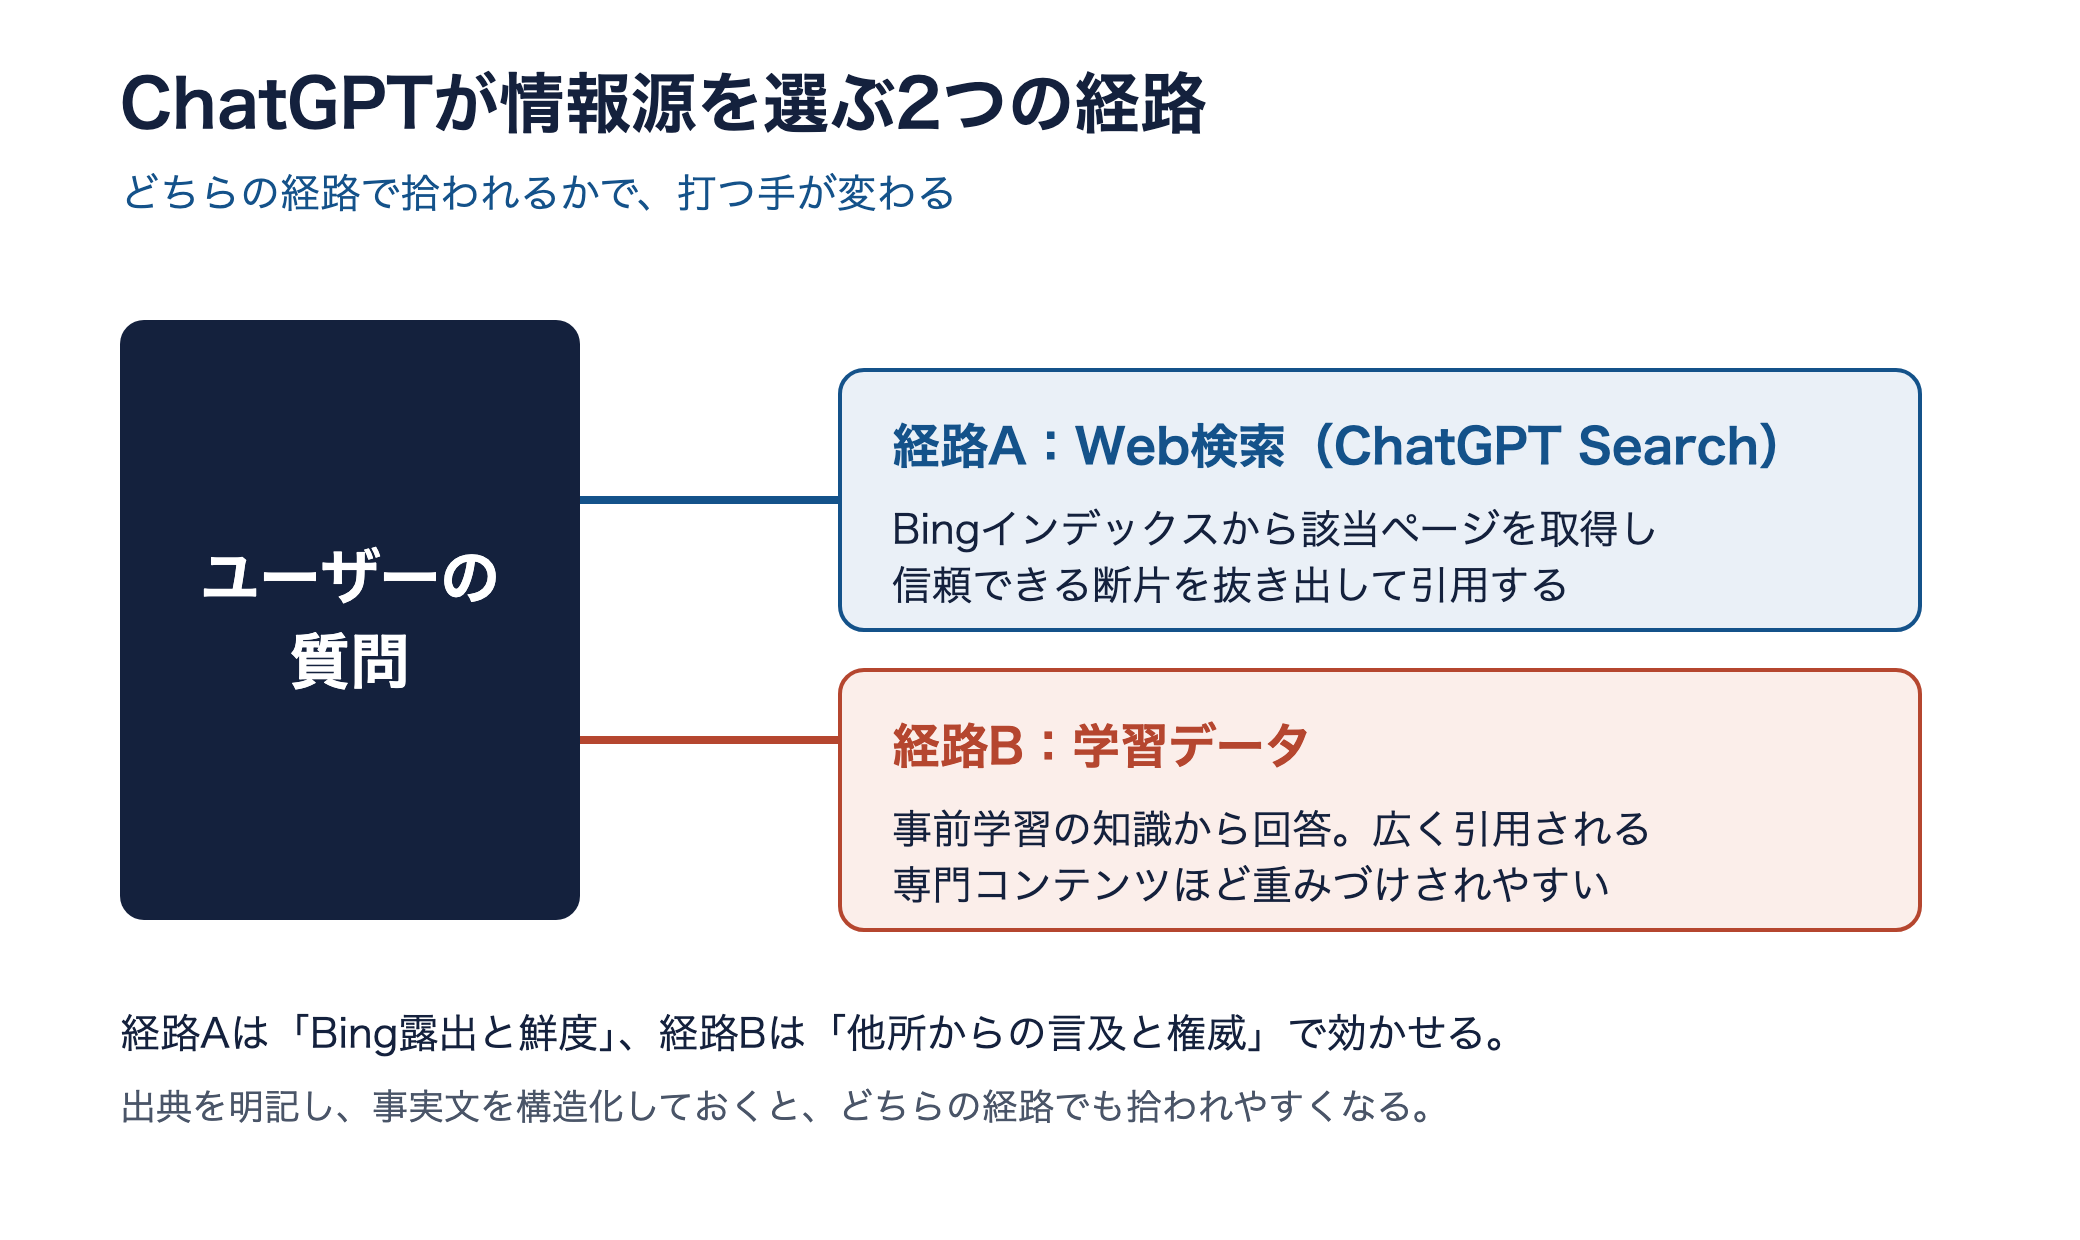
経路A:Web検索(ChatGPT Search)はBingインデックス依存
ChatGPTが最新情報を必要とする質問に答えるとき、内部でWeb検索が走ります。ここで使われる検索インデックスはGoogleではなくBingです。つまり、質問に関連するページをBingから取得し、その中から信頼できそうな断片を抜き出して回答に組み込む流れになります。ここが最初の分かれ目です。Googleで上位に出ていても、Bingにインデックスされていなければ、この経路では拾われません。Google検索順位が高い=ChatGPTに引用される、という等式は成り立たないわけです。まずBingウェブマスターツールに自社サイトを登録し、対象ページがBing側でも検索結果に出るかを確認するところが起点になります。
この経路でもう1つ効くのが鮮度です。Web検索経由の回答は、更新日時が新しいページを優先的に拾う傾向があります。数値や事例が古いまま放置された記事は、内容が正しくても後回しにされやすい。逆に、統計や事例を最新版に差し替え、更新日を動かしている記事は候補に上がりやすくなります。Bingに載せる、そして情報を鮮度良く保つ。経路Aで引用の土俵に乗るための前提は、この2点に集約されます。
ここで見落とされがちなのが、更新日の「実質」です。本文を触らずに公開日だけ書き換えても、AIやBingは中身の変化を見ています。統計を最新年のものに差し替える、新しい事例を1つ足す、古くなった記述を削る。こうした実際の手入れとセットで更新日を動かすことに意味があります。形式だけの日付更新は、短期的には拾われても、内容が伴わなければ続きません。主力記事に絞って四半期に一度は中身を見直す、といった運用ルールを決めておくと、鮮度の維持が現実的なタスクに落ちます。
経路B:学習データは「広く引用される専門コンテンツ」が優遇される
もう1つが、事前学習された知識から答える経路です。こちらはリアルタイム検索が走らず、出典リンクも表示されないことが多い。モデルの内部で、広く引用され、専門性が高いと判断されたコンテンツほど重みづけされて回答に反映されます。ここで効くのは、個別ページの小手先の最適化ではなく、ドメイン全体が他所からどれだけ言及されているかです。第三者メディアでの紹介、業界内での被リンクや引用、ブランド名での指名検索。こうした外部からの信号が積み上がっているほど、学習データ経路でも自社の情報が滲み出やすくなります。
実務上まず確認したいのは、自分の記事がどちらの経路で拾われうるかです。ChatGPTに対象KWを実際に質問し、回答に出典リンクが出れば経路A、リンクなしで一般論として語られるなら経路Bが主に働いている、とおおまかに切り分けられます。出典リンクが出るのに自社が入っていないなら、Bing露出か鮮度か構造の問題。そもそもリンクが出ない領域なら、言及と権威を積む長期戦になります。同じ「引用されない」でも原因が違えば処方箋も変わるため、この切り分けを先にやると打ち手の無駄打ちが減ります。
2経路をまとめると、経路Aは「Bing露出と鮮度」、経路Bは「他所からの言及と権威」で効かせる、という役割分担になります。片方だけでは足りません。Bingに載っていても言及が薄ければ経路Bで負け、権威があっても更新を止めれば経路Aで取りこぼす。どちらの経路でも共通して効くのが、出典を明記し、事実を明快な文で構造化しておくことです。次の章では、この「どちらの経路でも拾われやすい記事」の共通条件を具体化します。
自社サイトがBingに載っているか、ChatGPTに拾われる条件を満たしているか。激安AI SEOが現状を診断し、引用されやすい記事設計まで低コストで伴走します。
引用される記事に共通する5条件|一次情報・事実文・出典・構造化・露出
2経路のどちらで拾われるにしても、選ばれる記事には共通の型があります。ChatGPTは長い文章を丸ごと引くのではなく、質問に対応する短い断片を抜き出して使います。だから「抜き出しやすく、そのまま信頼して載せられる断片」を記事の中に用意できているかが分かれ目です。ここでは、その断片になりやすくする5つの条件を、上流から順に整理します。景品表示法の観点から先に断っておくと、これらは引用を保証する魔法ではありません。あくまで引用される確率を上げる条件整備です。
条件1・2:独自の一次情報と、1文1結論の明快な事実文
まず土台になるのが一次情報です。自社データ、独自調査、実験結果、取材で得た数字。他社がまとめ直せない固有の事実は、AIにとって引用する価値が高い断片になります。二次情報の焼き直しは、同じ内容を持つページが無数にあるため、あえて自社を選ぶ理由が生まれません。次に効くのが文の書き方です。1つの文に結論を1つだけ置き、主語を省かず、「これ」「その」といった指示語で受けすぎない。たとえば「これは効果的です」ではなく「FAQ構造化データの実装は引用率を高めます」と書く。AIが1文だけを切り出しても意味が通るように書くことが、断片として選ばれる確率を上げます。結論を段落の先頭に置くPREP型も、この「切り出しても崩れない」設計の一部です。
一次情報が用意できないテーマでも、打つ手はあります。既存の公的統計や調査を複数つき合わせ、自社の視点で解釈を加えるだけでも、単なる焼き直しから一歩抜けられます。数字をそのまま並べるのではなく、「この2つの調査を並べると、鮮度が効いていると読める」といった読み解きを添える。その解釈自体が、他所にはない断片になります。加えて、定義や手順のように問い合わせが集中する情報は、記事の冒頭付近に短く言い切る形で置くと拾われやすい。「〇〇とは」で始まる一文を見出し直下に置くだけでも、AIが定義を探すときの候補に入りやすくなります。
条件3・4:出典の明記と、FAQ・JSON-LDによる構造化
3つ目は出典の明記です。記事内の数値や主張に、いつ・誰が・どの範囲で出した情報かを添える。出典タイトル、公開日、調査対象を具体的に書いた記事ほど、AIは「裏取りされた事実」として扱いやすくなります。4つ目が構造化です。見出しの階層を整え、要点を箇条書きや表にし、想定質問をFAQ形式で置く。人が拾いやすい形は、AIにとっても拾いやすい形です。技術面では、schema.orgのFAQPageやArticleをJSON-LDでマークアップし、著者・監修者・組織情報を構造化データで明示すると、機械が内容と信頼性を解釈する手がかりが増えます。ここまでの条件を、満たす記事と満たさない記事で並べると差がはっきりします。
出典の書き方には、引用されやすさを左右する細かな作法があります。「ある調査によると」ではなく「総務省 令和7年版情報通信白書によると」と、発行主体と資料名まで書き切る。数字には調査年と対象規模(n数)を添える。この粒度で書かれた事実文は、AIが回答に使う際、そのまま出典として提示しやすくなります。逆に、出どころの曖昧な数字は、たとえ正しくてもAIが引用を避ける要因になります。FAQセクションも、質問文を実際の検索クエリに近い自然な疑問文にすると効果が上がります。「料金は」ではなく「ChatGPTに引用されるまでどれくらいかかりますか」のように、ユーザーが打ち込む言葉へ寄せるのがコツです。
| 観点 | 引用されにくい記事 | 引用されやすい記事 |
|---|---|---|
| 情報の出どころ | 他社記事のまとめ直し(二次情報) | 自社データ・独自調査・取材(一次情報) |
| 文の作り | 1文に複数の主張、指示語が多い | 1文1結論、主語が明確で切り出せる |
| 出典 | 数値の根拠が不明、リンクなし | 調査元・日付・対象を明記しリンク |
| 構造 | 見出しが抽象的、地の文の羅列 | FAQ・表・箇条書き+JSON-LD |
| 露出 | 自社ドメイン内で完結、被言及が薄い | 第三者メディア・ランキングで言及される |
条件5:話題ドメインでの露出と第三者からの言及
5つ目が露出です。ここが自社サイト単体では完結しない部分になります。ChatGPTは、多くの場所で言及されている情報源を信頼しやすい。自社ドメイン内でどれだけ良い記事を書いても、外から言及されていなければ、経路Bの重みづけは上がりにくいままです。プレスリリースで一次情報を配信する、業界メディアの比較記事に載る、noteのような露出の高いドメインで発信する。こうした「他所に自社の名前と事実が置かれる」状態を作ることが、引用の確率を底上げします。この露出の効き方は、次章の実データではっきり数字に表れています。
露出づくりでよくある誤解が、被リンクの数を増やせばよいという発想です。ChatGPTの引用で効くのは、リンクの本数そのものより、信頼できる文脈で自社の名前と事実がセットで語られている状態です。無関係なサイトからの機械的なリンクは効きません。一方、業界メディアが比較記事の中で自社サービスを実名で取り上げ、その特徴を1文で説明してくれるような言及は、経路Bの重みづけに直結します。自社発信と第三者発信を両輪で回すこと。この2つがそろって初めて、露出が引用へ変わり始めます。5条件は独立した施策ではなく、一次情報という土台の上に、事実文・出典・構造・露出を積み上げる一続きの流れとして設計するのが要点です。
【実データ】ChatGPTが引用しやすいドメイン傾向|Ahrefs調査で見る
引用される条件を、実際の引用データで裏づけます。SEOツールのAhrefsは、AIが引用したドメインをBrand Radarで集計しています。2025年12月から2026年3月の累計で、ChatGPTが引用したドメインの上位を並べると、傾向がくっきり出ます。1位はAmeblo、2位はPR TIMES。個人ブログとプレスリリース配信が、大手ニュースサイトを抑えて上位に来ています。
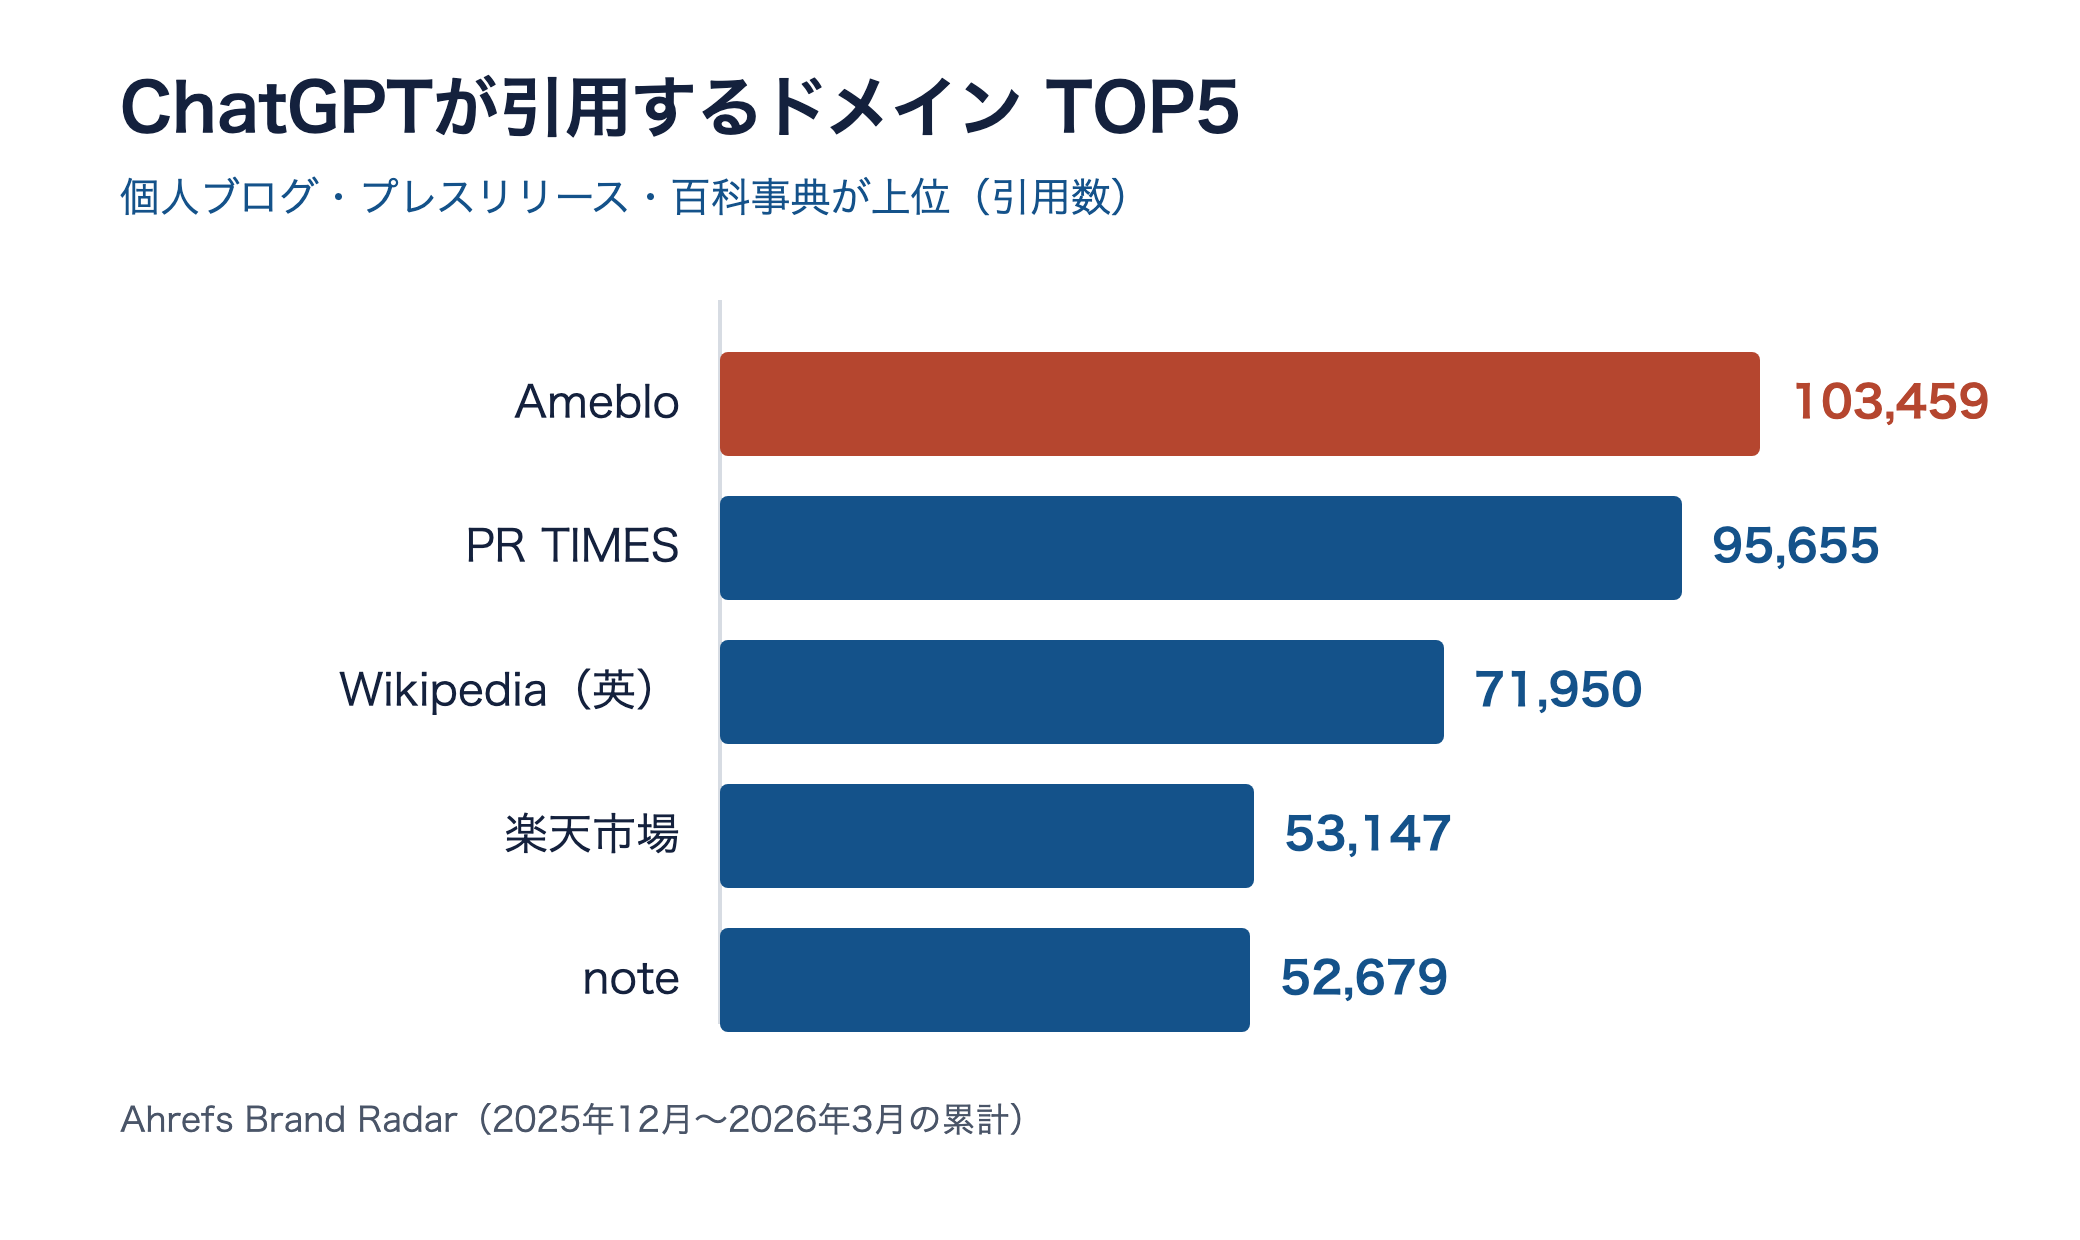
この並びが示すのは、ドメインの知名度や規模より、発信の量と鮮度が効いているという事実です。Amebloやnoteが上位なのは、更新が活発で、話題性のある一次情報が日々投稿されているから。PR TIMESが強いのは、企業の一次発表がそのまま集まる場所だからです。ここから読める実装のヒントは明確で、自社ドメインで完璧な記事を1本磨くより、露出の高い場所に一次情報を継続的に置くほうが、引用には近いということになります。もう1つ、引用ソースの中身を分析したデータも見ておきます。
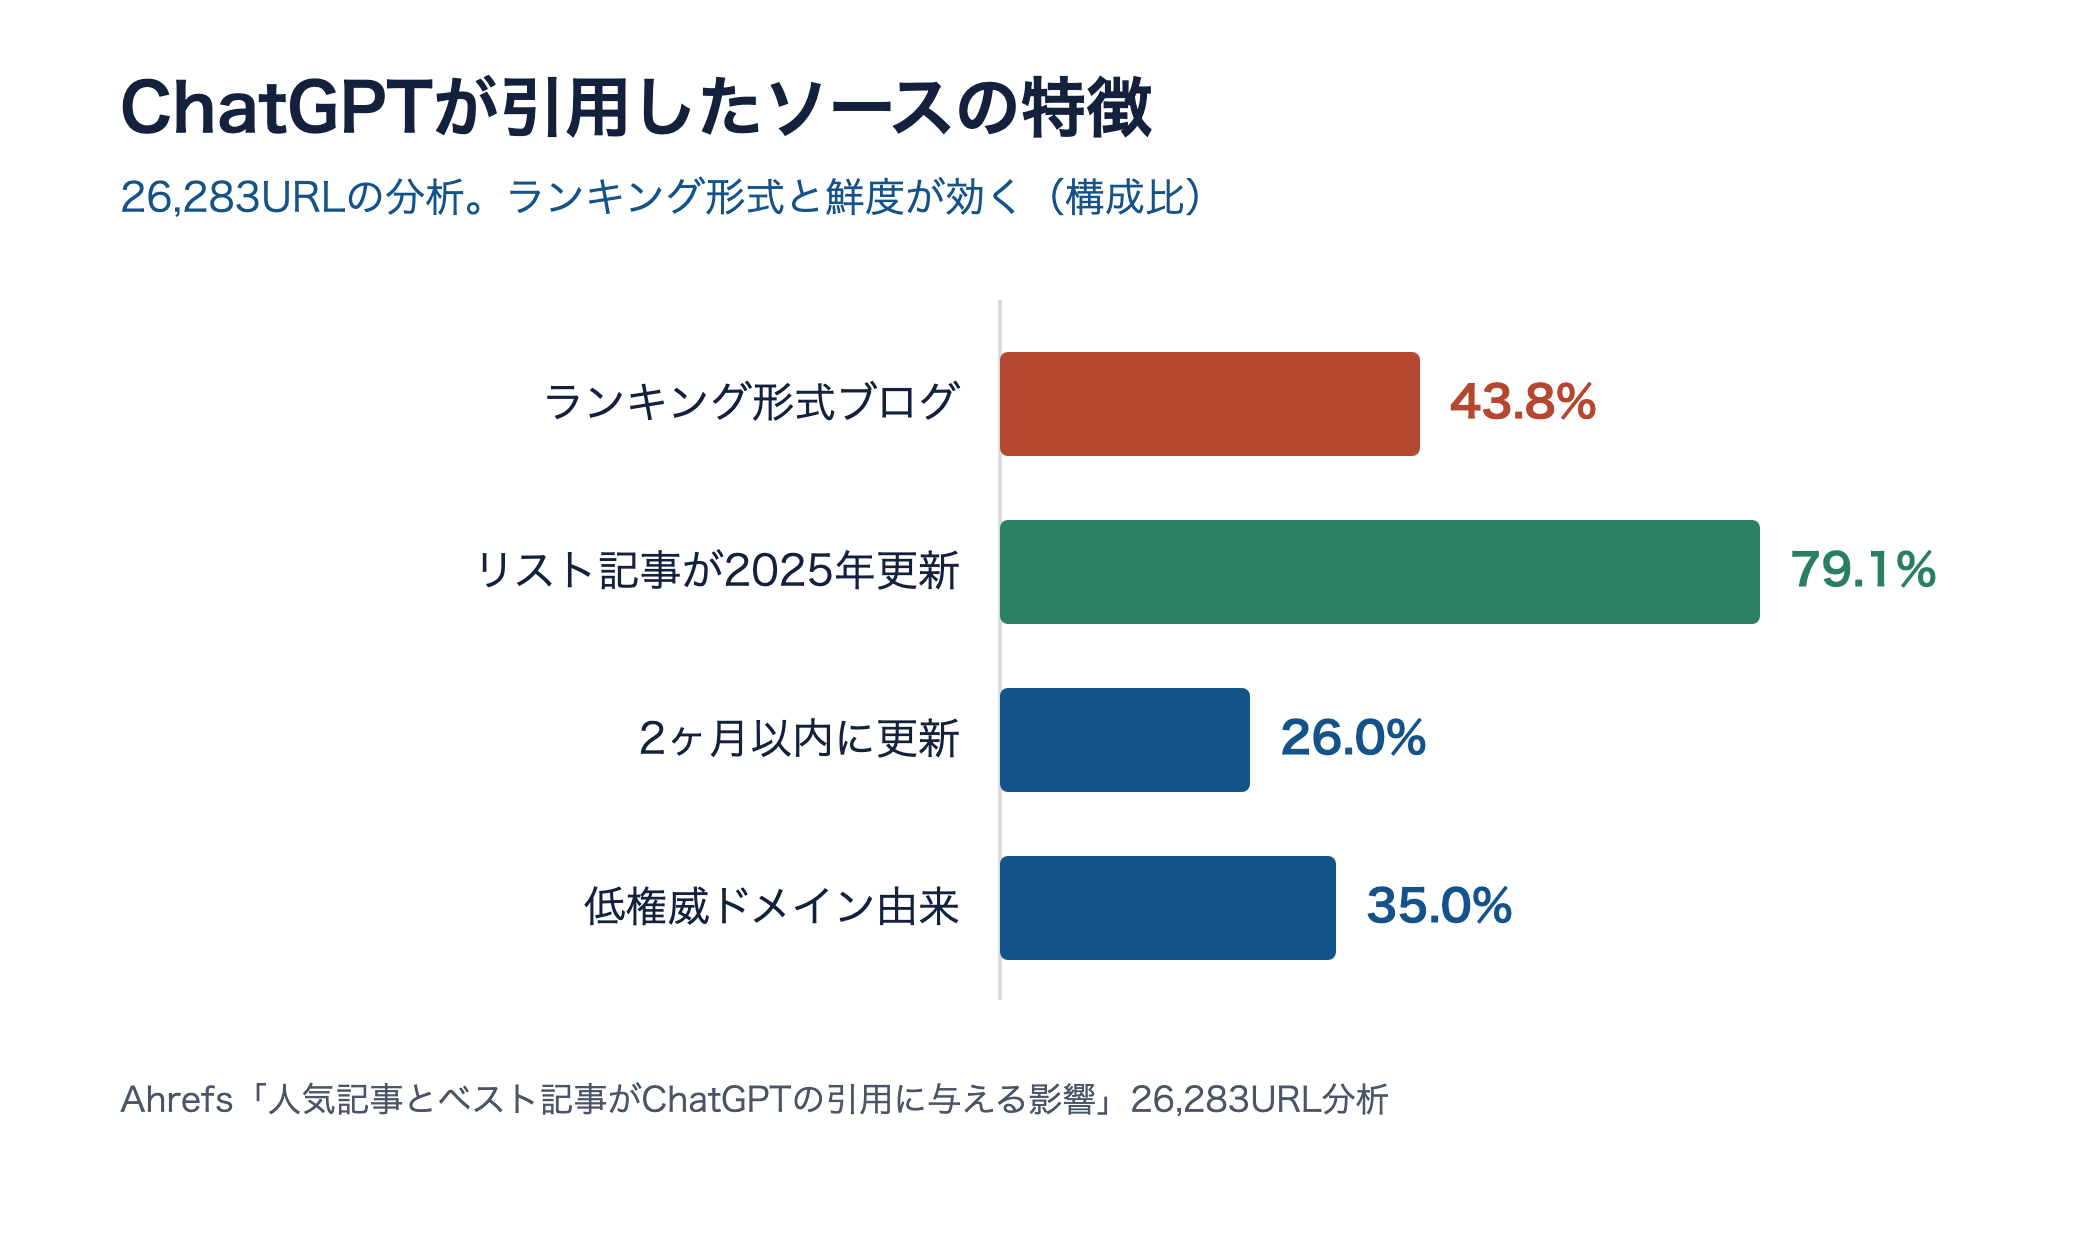
Ahrefsが26,283件のURLを分析したところ、ChatGPTが引用したソースリンクの43.8%が「○○選」型のランキング・比較記事でした。しかも、引用されたリスト記事の79.1%が2025年に更新され、26%は直近2ヶ月以内に更新されています。鮮度が引用に直結していることが、ここでも裏づけられます。一方で注意点もあります。引用された「ベスト記事」の約35%は、権威の低いドメイン由来でした。AI側の情報源の見極めはまだ発展途上で、質より鮮度と形式で拾われている面がある、という現実も同時に押さえておくべきです。だからこそ、鮮度と形式を満たしつつ、一次情報と出典で質も担保した記事が、中長期では有利になります。
この2つのデータを自社の動きに翻訳すると、優先順位が見えてきます。BtoBのサービスサイトなら、まず「〇〇 比較」「〇〇 おすすめ」に対応するランキング・比較記事を1本、鮮度を保って運用する。個人や小規模なら、AmebloやnoteのようにChatGPTが好んで引く外部ドメインで一次情報を発信し、自社サイトへ流す。どちらも共通するのは、質の高い記事を放置するのではなく、更新し続ける前提で設計することです。引用は一度されたら終わりではなく、鮮度が落ちれば離れていく。この動き続けるランキングの中で位置を保つ、という感覚が実装の軸になります。
ランキング記事の設計、一次情報の配信、更新頻度の維持。引用に効く打ち手を一気通貫で回すのは手間がかかります。激安AI SEOなら、この工程を低コストで継続できます。
自社サイトでの実装手順|引用条件を記事に落とす4ステップ
仕組みと条件が分かったら、自社サイトへの落とし込みです。ここまでの内容を、着手しやすい順に4ステップへ整理します。難易度と効き方が違うので、費用対効果の高いものから手を付けるのが現実的です。まず表で全体像を俯瞰し、そのあと各ステップを具体化します。
| ステップ | 具体的な打ち手 | 着手の重さ | 効く経路 |
|---|---|---|---|
| 1. 事実文へ書き直す | 1文1結論、結論ファースト、指示語を削る | 軽い | A・B |
| 2. 出典と構造化を整える | 出典明記、著者・監修、FAQ、JSON-LD | 中 | A・B |
| 3. Bing露出と更新を担保 | Bing登録、更新日の維持、統計の差し替え | 中 | A |
| 4. 露出・第三者言及を作る | プレスリリース、比較記事掲載、指名検索 | 重い | B |
Step1・2:既存記事を事実文に直し、出典と構造化データを付ける
最初の一手は、いま公開している主力記事の書き直しです。新規記事を増やす前に、流入のある既存ページを事実文へ整えるほうが、費用対効果が高い。1文に主張を詰め込みすぎている箇所を分割し、各段落の先頭に結論を置き、数値には出典リンクを付ける。この作業は外注でも社内でもすぐ着手できます。続けてStep2で、著者名と監修者、組織情報を明示し、FAQセクションとJSON-LDを追加します。ここまでで、経路A・B双方で「抜き出しやすく信頼できる断片」を持つ記事に変わります。JSON-LDは一度テンプレート化すれば横展開が利くので、初期の設計だけ丁寧にやる価値があります。書き直しの優先順位は、直近で流入や問い合わせにつながっている記事から。アクセスの多いページほど、引用されたときの効果も大きいためです。
Step3・4:Bingインデックスと更新頻度、そして外部露出を積む
Step3は経路Aの前提づくりです。Bingウェブマスターツールに登録し、主要ページがBingで検索結果に出るかを確認する。そのうえで、統計や事例を定期的に最新へ差し替え、更新日を動かします。更新を止めた記事から引用が離れていくのは、実データが示すとおりです。Step4は最も重いぶん、経路Bで効きます。一次情報をプレスリリースで配信し、業界メディアの比較・ランキング記事に載り、ブランド名で指名検索されるだけの認知を作る。Ahrefsのデータで上位だったPR TIMESやAmebloの傾向は、この「外に一次情報を置く」動きがそのまま引用につながることを示しています。ここで前提になるのが、AI任せの量産では上位も引用も取りにくいという事実です。
Step4を無理なく回すには、自社で作れる一次情報を素材化するのが近道です。既存顧客へのアンケート、サービス利用データの集計、社内の実験結果。こうした自社にしかない数字を、まずプレスリリースとして配信し、同じ数字を自社記事にも一次情報として載せる。1つの調査を、外部露出(PR TIMES)と自社の事実文(記事内)の両方に使い回せば、経路Bの言及と経路Aの断片を同時に作れます。ネタ切れを防ぐ意味でも、四半期に1つ小さな自社調査を回す、といったリズムを持てると、露出づくりが継続的なタスクとして定着します。
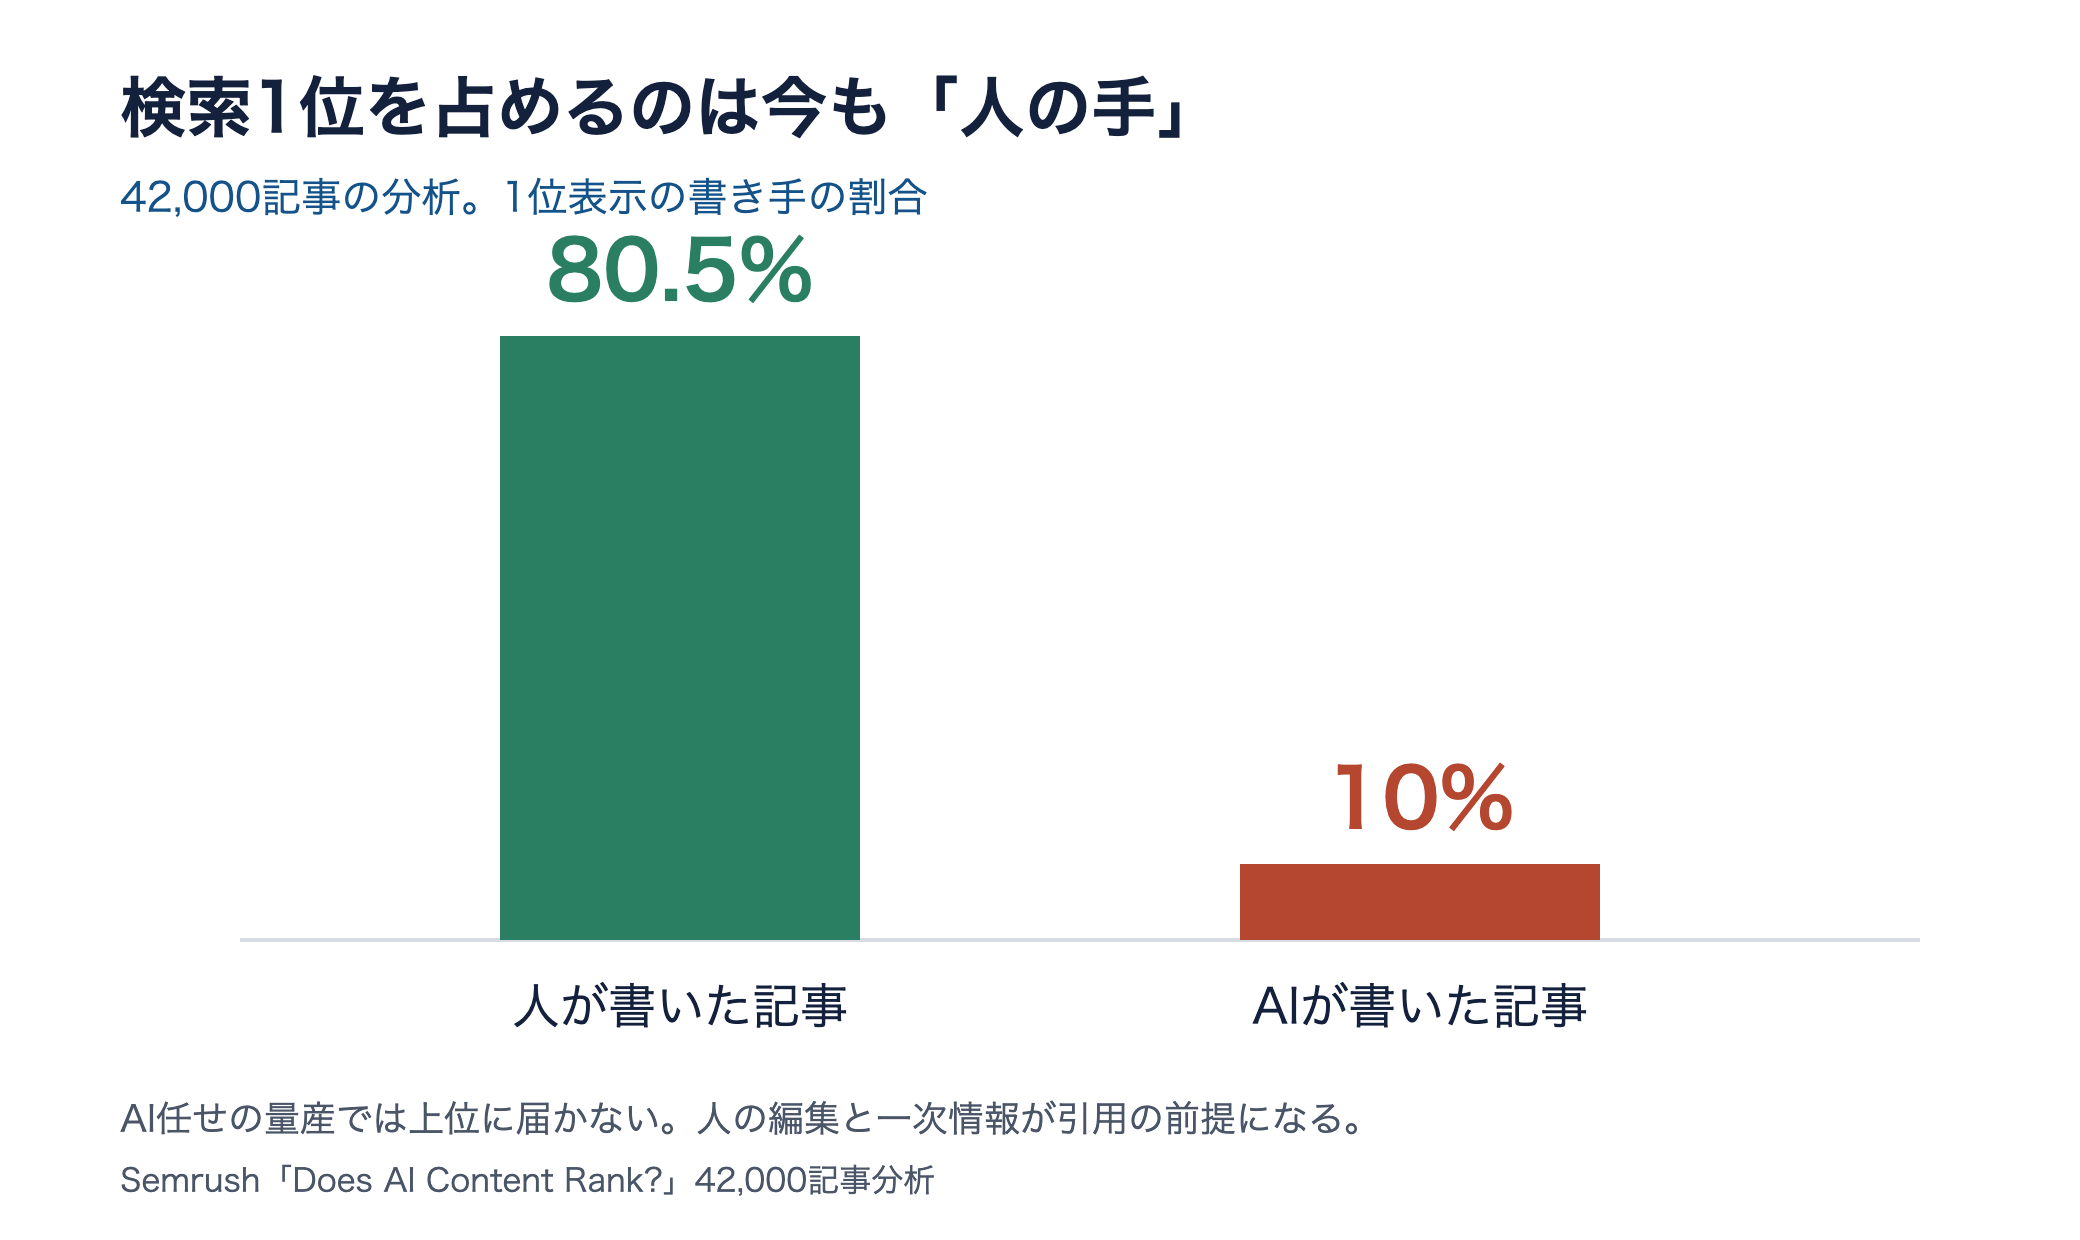
Semrushが42,000記事を分析した結果では、検索1位を占める記事の80.5%が人の手によるもので、AI生成のみは10%にとどまりました。Google自身も、コンテンツの制作手段ではなく品質で評価する立場を公式に示しています(Google 検索セントラル AIコンテンツの方針)。SEO支援のLANYも、AIを使う場合でも人手によるE-E-A-Tの付与とファクトチェックが欠かせないと整理しています(LANY「AI SEO」)。引用を狙ううえでのAIの役割は、原稿を丸ごと生成させることではなく、書き直しや構造化を高速化する道具として使い、一次情報と検証は人が担う分業にあります。生成AIの活用方針を定める企業は総務省の令和7年版情報通信白書で49.7%まで伸びており(総務省 令和7年版情報通信白書)、道具として使いこなす前提はすでに整いつつあります。
着手後は、成果の確認方法も決めておきます。対象KWや関連する質問文を月に一度ChatGPTへ投げ、回答に自社が出るか、出典リンクに入るかを記録する。順位のように毎日動く指標ではないので、月次で定点観測すれば十分です。あわせてBing Webmaster Toolsで対象ページのインデックス状況を見ておくと、経路Aで拾われる前提が崩れていないか確認できます。数値が動かない月が続くなら、鮮度(更新)か露出(言及)のどちらが足りていないかを疑い、Step3かStep4に立ち返る。この観測と手直しのループが、引用対策の実務そのものになります。
ChatGPT引用対策のよくある質問|Bing・FAQ・効果が出るまでの期間
実装を進めると、判断に迷う細かな疑問が出てきます。問い合わせで多いものを、これまでの内容をふまえて整理します。
Google検索で1位なら、ChatGPTにも引用される?
直結しません。ChatGPTのWeb検索はBingのインデックスを使うため、Googleでの順位はそのまま引用に反映されません。Googleで上位でも、Bingにインデックスされていなければ経路Aでは拾われないことが起こります。まずBing Webmaster Toolsで自社ページがBing側にも載っているかを確認し、載っていなければ登録とサイトマップ送信から始めるのが先決です。Google対策とBing対策は重なる部分も多いものの、引用を狙うならBing側の露出を別途チェックする一手間が要ります。
FAQや構造化データを付ければ引用される?
FAQやJSON-LDは引用されやすさを高める条件の1つであって、それ単体で引用を約束するものではありません。構造化はAIが内容を解釈する手がかりを増やしますが、肝心の中身が二次情報の焼き直しなら、選ばれる理由は生まれにくい。順序としては、一次情報と明快な事実文という中身を整えたうえで、FAQや構造化データで「拾いやすさ」を足すのが正しい積み方です。器だけ立派でも中身が薄ければ引用には届きません。
対策してからどれくらいで引用される?
明確な保証はできませんが、鮮度が引用に効くことは実データが示しています。Ahrefsの分析では、引用されたリスト記事の約8割が直近1年以内に更新され、4分の1が2ヶ月以内の更新でした。裏を返せば、更新を止めた記事は候補から外れていきます。短期の一発勝負ではなく、記事を最新に保ち、露出を積み続ける中で徐々に引用が増える、という時間軸で考えるのが現実的です。月次で定点観測し、動きが鈍ければ鮮度か露出を見直す運用が向いています。
AIで書いた記事はChatGPTに引用されない?
制作手段そのものは問題になりません。Googleも品質で評価する立場を示しており、AI生成であること自体を理由に評価を下げるわけではありません。ただしSemrushの分析どおり、検索1位の8割は人の手による記事で、AI任せの量産では上位も引用も取りにくいのが実情です。AIは書き直しや構造化を速める道具として使い、一次情報の用意とファクトチェックは人が担う。この分業ができていれば、AIを使うこと自体は引用の妨げになりません。
ここまでの条件と手順は、一度に全部そろえる必要はありません。まず流入のある主力記事を1本選び、事実文へ書き直して出典とFAQを足すところから始める。次にBing登録と更新の仕組みを整え、そこまで回ってからプレスリリースや比較記事での露出に広げる。この順で1サイクル回せば、経路Aと経路Bの両方に自社の情報が乗り始めます。引用は保証できるものではありませんが、条件を満たした記事だけが候補に残るのは確かです。まずは主力記事1本の書き直しから、今日着手できます。
事実文への書き直し、JSON-LDの実装、一次情報の配信までを一定品質で回すなら、激安AI SEO。AIで工程を高速化しつつ、人手の検証と一次情報を残した設計で、引用条件の整備を低コストで支援します。