目次
なぜ「独自性」のないSEO記事は評価されないのか|Googleが引く線
「上位10本を読んで、良いところを取り込んで書く」。SEO記事の定番手順ですが、この作り方の延長線上に、順位が上がらない記事の大半があります。理由は単純で、上位を平均化した記事は、上位の誰にも勝てないからです。検索結果の1ページ目には、すでに似た情報が並んでいます。そこへ11本目の要約を足しても、Googleにとっては選ぶ理由のないページが1枚増えるだけ。差別化と独自性は、順位を上げるための装飾ではなく、そもそも土俵に乗るための前提条件になっています。ここを設計として扱えるかどうかが、最初の分かれ目です。
この問題は、生成AIの普及で一段深刻になりました。誰でも数分でそれらしい記事を出力できるようになり、検索結果には「平均的で正しいが、どこかで読んだ」記事が急速に増えています。総務省の令和7年版情報通信白書によると、生成AIの活用方針を定めている企業は49.7%に達しました(総務省 令和7年版情報通信白書)。競合の半数がAIで量産を始めれば、平均に寄せる書き方の価値は相対的に下がります。皮肉なことに、AIで書ける情報ほど独自性がなく、AIには書けない情報ほど独自性になる。この非対称が、いまの差別化の出発点です。何を足せば「AIには書けない1本」になるのか。答えは大きく4つに整理できます。
「まとめ直し」をスパム扱いするGoogleの定義
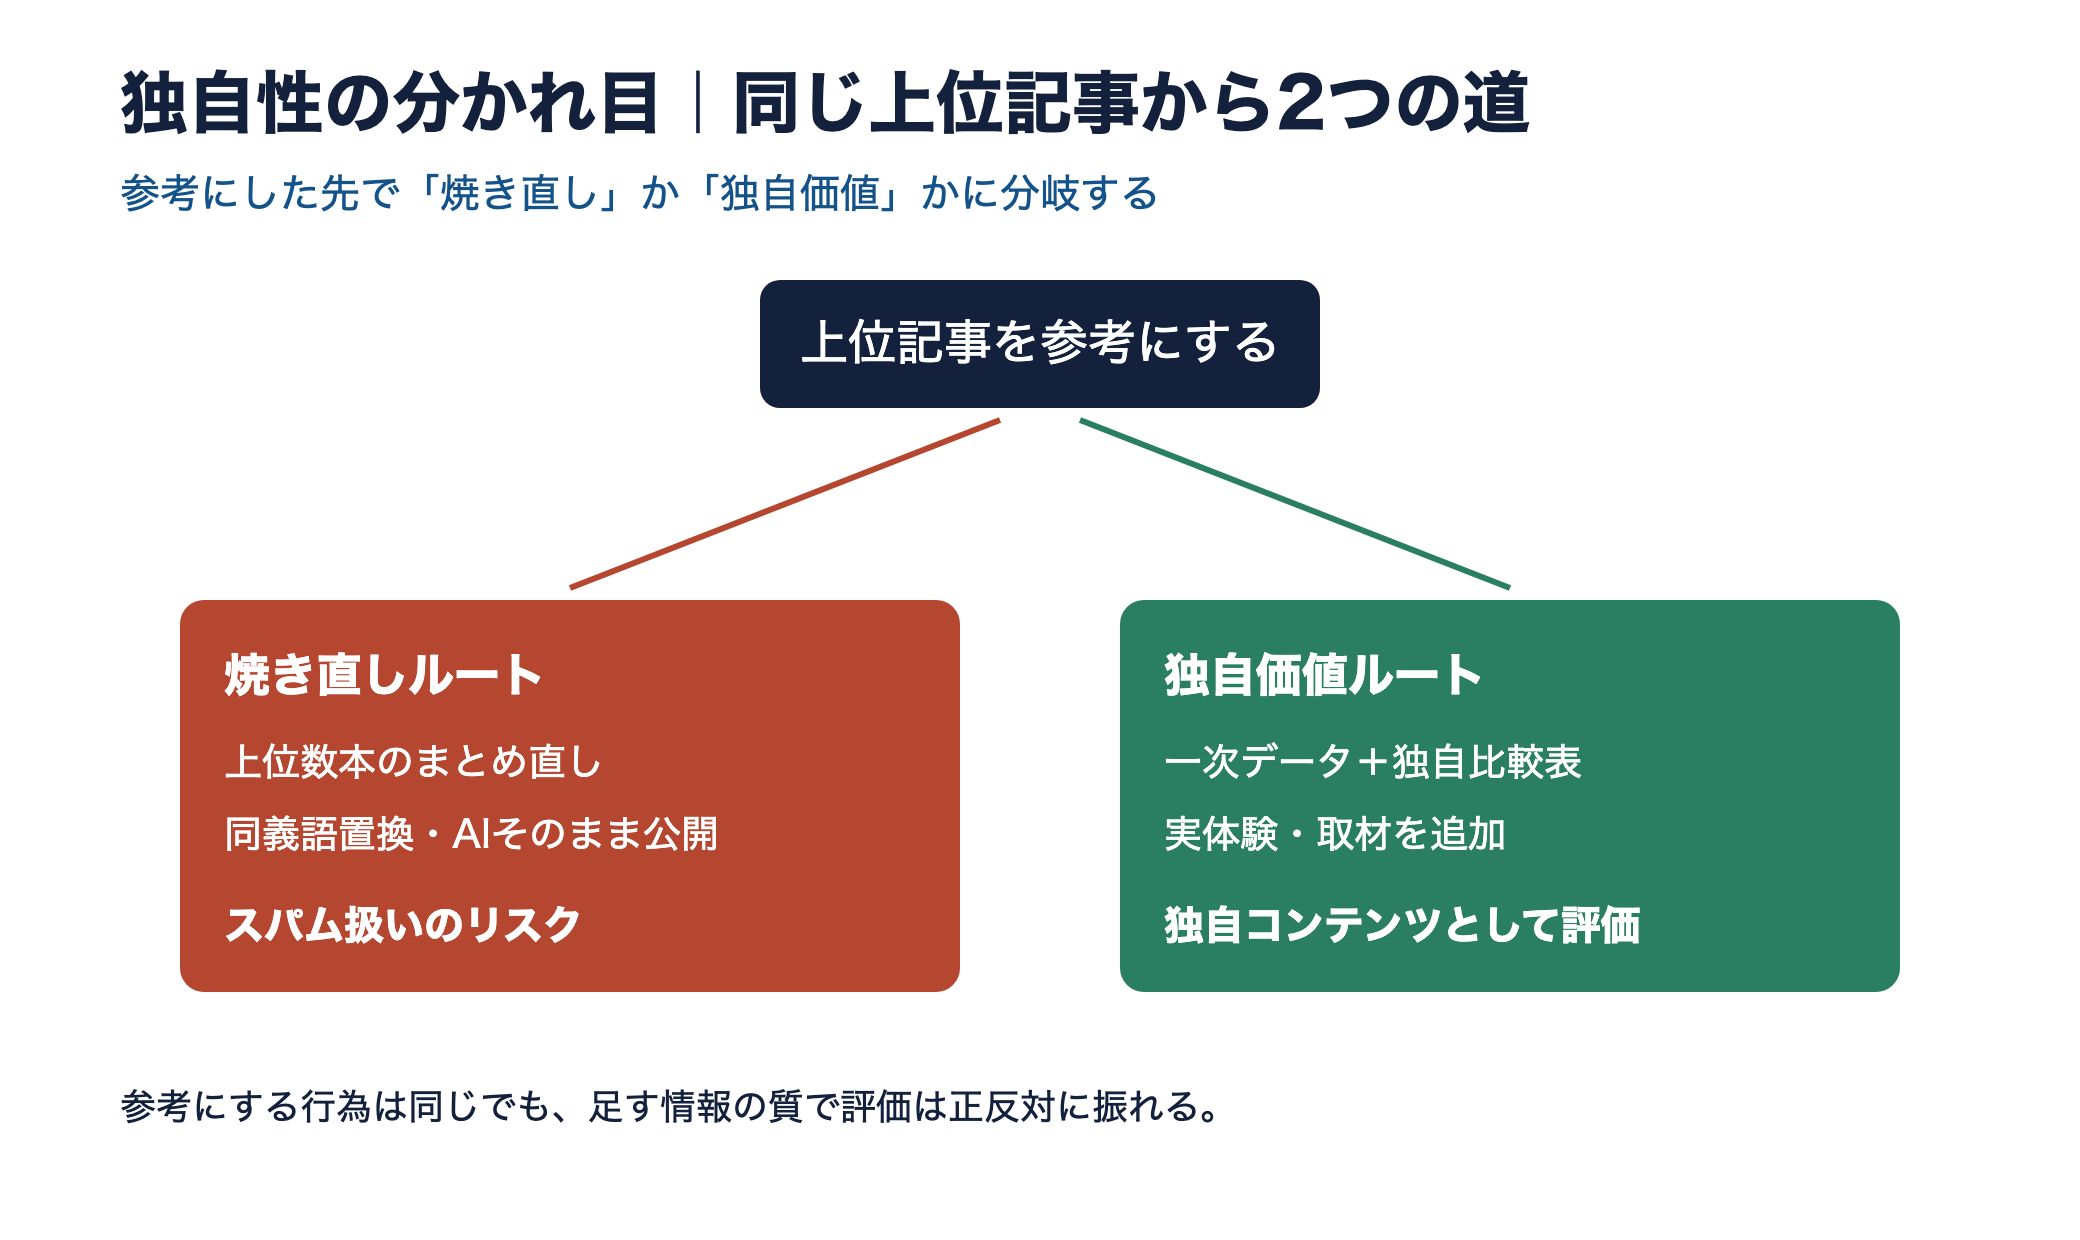
この感覚論には、Googleの公式ドキュメントという裏づけがあります。検索セントラルのスパムポリシーは、検索順位の操作を主目的に大量生成されたページを「スケーリングされたコンテンツの不正利用」と定義し、対象として「フィードや検索結果、その他のコンテンツをスクレイピングし、同義語への置き換えや翻訳などの自動変換でユーザーにほとんど価値を提供しない多数のページを生成する」行為を挙げています。別項の「スクレイピング」では、他サイトの内容を同義語置換などでわずかに改変して再公開する行為も、独自の価値がなければ対象になると明記されています。つまり「上位のまとめ直し」「言い回しを変えただけのリライト」は、Googleの言葉では独自性の欠如どころか、スパムの一歩手前に位置づけられています。参考にすること自体は問題ではありません。問題は、参照した情報に何も足さないまま公開する点にあります。
ここで鍵になるのが「十分な付加価値(value add)」という考え方です。Googleは、複数のページを寄せ集めても十分な価値を加えなければ評価しない、と繰り返し示しています。逆に言えば、独自の分析、実測データ、専門家の解釈、現場でしか得られない具体例といった「元の情報にはなかったもの」を足せば、同じ題材でも別のコンテンツになります。判断基準はシンプルで、その記事から自分の言葉・データ・図を全部抜いたとき、上位10本の要約だけが残るなら、それは焼き直しです。反対に、抜いたら成立しない固有の要素が1つでもあれば、独自性の芽があります。この「抜いても残るか」テストは、公開前に自分の記事を疑う手っ取り早い問いになります。
評価されるのは制作手段でなく「独自価値」とE-E-A-T
裏を返すと、独自の価値さえ足せば、AIを使おうが上位を参考にしようが評価の対象になります。Googleは2023年のAI生成コンテンツに関する方針で、コンテンツを制作手段ではなく品質で評価する立場を示しました(Google 検索セントラル AIコンテンツの方針)。人が書いたかAIが書いたかを問うのではなく、誰が・どのように・なぜ作ったかという観点で、ユーザーのためのオリジナルな情報かを見る。ここで効いてくるのがE-E-A-T、とりわけ最初のE(経験)です。実際に使った、試した、取材したという一次の経験は、上位10本の平均には決して含まれません。独自性とは才能やセンスの話ではなく、「他の誰も持っていない情報や視点を、この1本に入れられるか」という設計の問題です。次の章から、その入れ方を4つの型に分けて具体化します。
経験を軸にすると、独自性のコストも下がります。ゼロから調査するのは大変でも、自分がすでにやったこと、社内にすでにある数字、担当者がすでに知っている失敗は、追加取材なしで書けます。E-E-A-Tは高尚な資格の話に聞こえますが、実務では「自分の手元にある一次情報を、面倒がらずに言語化する」というだけのことです。多くの記事が独自性を欠くのは、書き手に経験がないからではなく、経験を書く工程を用意していないから。ここを仕組みに変えれば、専門家でなくても独自性は積み上がります。
独自性を出す4つの型|切り口・一次データ・独自比較表・実体験
独自性を「センスで出すもの」と捉えると再現できません。分解すると、実務で使える型は4つに集約できます。独自の切り口、複数の一次データの組み合わせ、独自比較表の自作、実体験や一次取材の差し込み。1つだけでも焼き直しから一歩抜けますが、本当の差は重ねたときに出ます。同じキーワードでも、角度をずらし、独自データを載せ、自作の表で見せ、現場の一言を添えれば、他記事とは別物になります。それぞれ何をするのかを順に見ていきます。
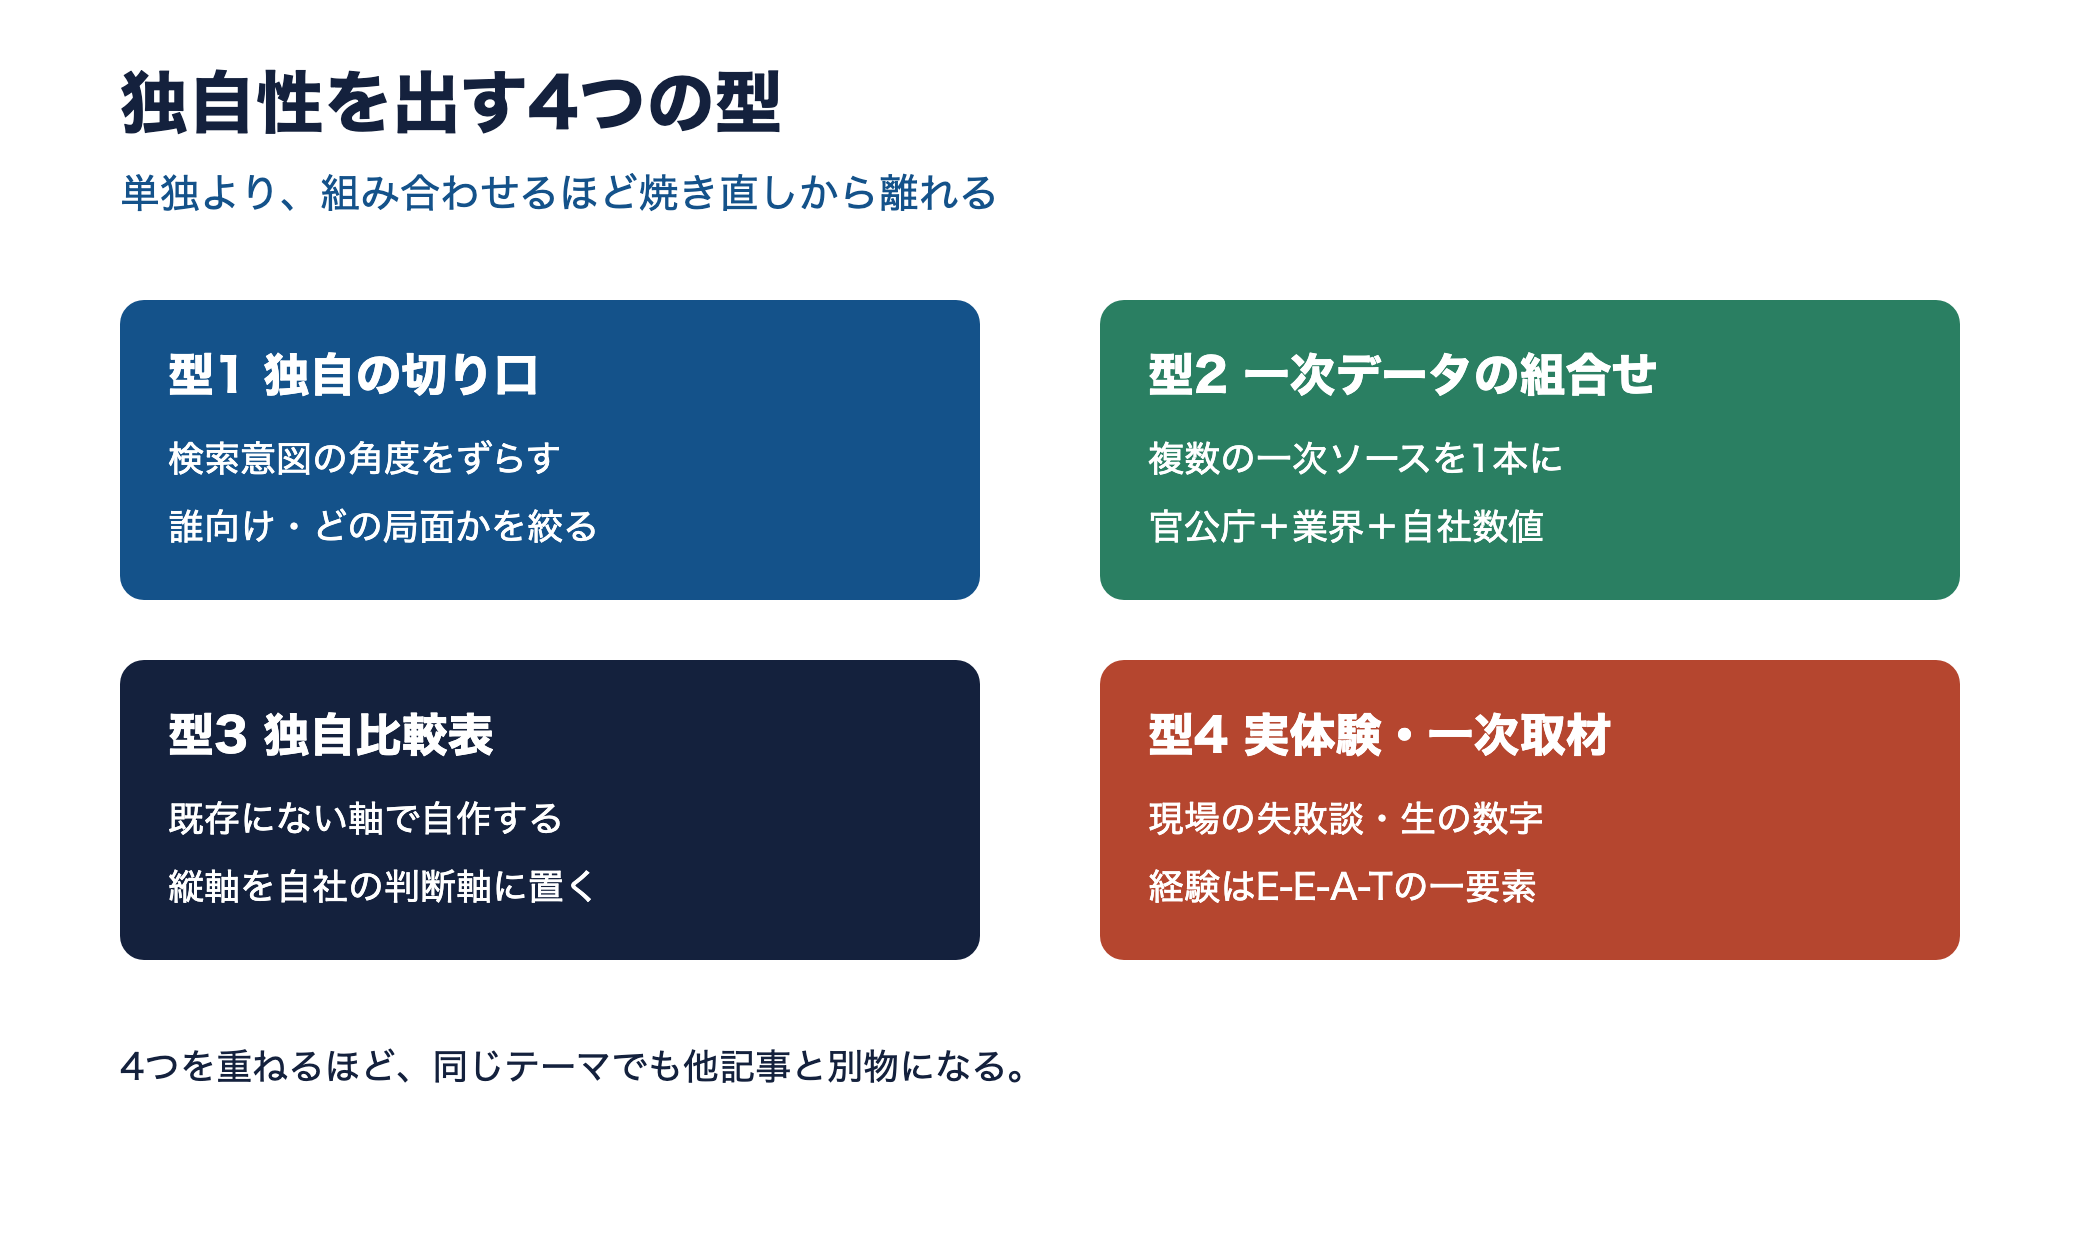
型1:検索意図の角度をずらす独自の切り口
1つ目は切り口です。同じキーワードでも、誰のどの局面に向けて書くかを絞ると、上位記事となぞらない角度が生まれます。たとえば「SEO記事 独自性」というテーマを、上位の多くは「独自性とは何か」の定義から入ります。そこを「上位を参考にしたのに似てしまう人」という具体の状況に絞れば、同じテーマでも問いの立て方が変わり、書く内容が自然にずれます。切り口を作る実務的な方法は、対象読者を一段狭めることです。初心者全般ではなく「外注ライターに独自性を指示する編集者」、企業全般ではなく「AIで量産して伸び悩む担当」。読者を狭めるほど、他記事が拾えていない固有の悩みに触れられます。ここが独自性の出発点になります。
切り口の作り方には、もう1つ実務的な近道があります。上位記事が「賛成」している前提を、あえて疑ってみることです。多くの記事が「独自性には独自調査が必要」と書くなら、こちらは「独自調査をしなくても、既存データの組み合わせと実体験で独自性は出せる」という立場を取る。反対の立場を取れる根拠さえあれば、それだけで角度が生まれます。注意したいのは、目立つための逆張りにしないこと。事実やデータで支えられない反対意見は、独自性ではなく単なる不正確さになります。立場は取るが、根拠から外れない。この線を守るほど、切り口は強くなります。
型2:複数の一次データを1本に組み合わせる
2つ目は一次データの組み合わせです。個々のデータは既出でも、複数を1つの主張のために束ねた瞬間、その構成は新しくなります。この記事も同じ手を使っています。記事外注で「類似コンテンツが複数本上がってきた」失敗が28.7%あるというEXIDEAの調査(2022年4月、n=106)、AIツールでSEO効果を実感した人が合計85.2%というランクエスト系の調査、生成AIの活用方針を定めた企業が49.7%という総務省の白書。この3つは別々の出典ですが、「独自性のないAI量産が増える一方で、独自性の欠如は現実に失敗を生んでいる」という1つの主張のために並べると、単独の引用にはない厚みが出ます。官公庁の統計、業界調査、自社の実数値を掛け合わせるのが王道です。数字には必ず一次ソースのリンクを付け、二次まとめの孫引きで終わらせないことが条件になります。
組み合わせで独自性を出すコツは、異なる立場のデータをぶつけることです。「AIは効果がある」というデータと「AIそのままは失敗する」というデータを並べると、単なる数字の羅列ではなく、緊張のある論点が立ち上がります。片方だけを引く記事は多くても、両方を突き合わせて解釈まで示す記事は少ない。その解釈こそが、あなたにしか書けない部分です。孫引きを避ける理由もここにあります。二次まとめを写すと、元データの文脈や調査条件が抜け落ち、解釈を誤ります。一次ソースに当たれば、n数や調査時期という細部まで踏まえて論じられ、その精度の差がそのまま独自性の差になります。
型3:既存にない独自比較表を自作する
3つ目は独自比較表です。比較表は上位記事にもよくありますが、多くは他社の表を流用したもの。だからこそ、比較する「軸」を自分で設計し直すと、それ自体が独自の資産になります。ポイントは縦軸です。世に出回る表が「料金・文字数・納期」で並ぶなら、こちらは「一次情報の有無・比較軸の独自性・経験の明示」といった、自社の判断基準そのものを軸に据える。同じ対象を比べても、軸が変われば結論も見え方も変わります。独自の軸を見つける手順は、自社が実際に意思決定するときに何を見ているかを言葉にすることです。発注担当なら「再委託の有無」を気にし、編集者なら「一次情報の量」を見る。そうした現場の判断基準は、汎用の比較記事にはまず載っていません。それを列として立てるだけで、表は一気に自分たちの資産になります。表は情報を整理する道具であると同時に、比較軸というかたちで書き手の視点を可視化する装置でもある。だから独自性の勝負どころになります。次に示すのは、独自性を出す4つの型を1枚に整理した表です。上位記事が「独自性の要素」を列挙して終わるのに対し、ここでは各型の源泉と、明日から使える一手までを対応させています。
| 型 | やること | 独自性の源泉 | すぐ使える一手 |
|---|---|---|---|
| 型1 独自の切り口 | 検索意図の角度をずらす | 同じテーマを別の問いから解く | 読者を「誰・どの局面」で一段狭める |
| 型2 一次データの組合せ | 複数の一次ソースを束ねる | 単独では既出でも組合せは新規 | 官公庁+業界調査+自社数値を並置 |
| 型3 独自比較表 | 既存にない軸で自作する | 比較軸そのものが独自資産 | 縦軸を自社視点の判断軸へ置換 |
| 型4 実体験・一次取材 | 現場の失敗談・生の数字を差す | 経験(E-E-A-Tの1つ目のE) | 自分の手元データ・取材コメント |
型4:実体験・一次取材を1段落だけでも差し込む
4つ目は実体験と一次取材です。E-E-A-Tの筆頭に置かれた経験は、コピーも要約もできない、いちばん堅い独自性です。全編を体験談にする必要はありません。1段落、あるいは1つの数字でも、自分の手元にしかない情報を差し込めば、記事の質感は変わります。実際に運用して得た数値、担当者に聞いた一言、自分が踏んだ失敗。「試したらこの設定だけ効果が薄かった」という現場の観察は、どの上位記事にも載っていません。取材のハードルが高ければ、社内の担当者へ5分ヒアリングするだけでも一次情報になります。ここで避けたいのは、経験を装った一般論です。読者は具体の粒度で本物かどうかを見抜きます。固有名詞、日付、実数を伴わない「経験談」は、かえって信頼を削ります。
一次取材を仕組みにするなら、記事を書く前に「この記事で1人に5分だけ聞くとしたら誰に何を聞くか」を決めておくのが効きます。営業担当なら顧客が実際に口にする言葉を、開発担当なら数字の裏側にある背景を持っています。その一言を直接引用として1つ入れるだけで、記事は途端に地に足がつきます。写真も同じで、自分で撮った現場の1枚は、素材集の綺麗な画像より独自性の面で勝ります。完璧な取材でなくていい。手が届く範囲の一次情報を1つ拾う習慣が、積み重なって他社が真似できない厚みになります。
4つの型を毎回1本に落とし込むのは、慣れないうちは手間がかかります。激安AI SEOは、独自の切り口設計から一次データの収集・独自比較表の作成までを標準工程に組み込み、低コストで独自性のある記事を仕組みで再現します。
やりがちなNG|上位まとめ直しとAIそのまま出力
独自性の出し方の裏返しが、避けるべきNGです。厄介なのは、どちらも「一見それらしい記事」ができてしまう点。だから気づかないまま量産され、後から順位が付かない原因になります。代表的な2つを、データとともに直視します。どちらも共通するのは「平均に寄る」という失敗の構造で、独自性の出し方を裏返せば、そのまま回避策になります。
NG1:上位記事のまとめ直し(類似コンテンツ量産の落とし穴)
1つ目は、上位を要約して1本にまとめる作り方です。効率はよく、それらしい網羅性も出ます。ただ、この手法は同じ検索結果に似た記事を増やすだけで、Googleが選ぶ理由を作れません。前章のスパムポリシーが示すとおり、独自の価値を足さないまとめ直しは、評価されないどころかリスク側に振れます。外注の現場でも同じ問題が起きています。EXIDEAの調査では、記事制作を外注して「類似コンテンツが複数本上がってきた」という失敗が28.7%、失敗理由の1位である「自社業界への知見・理解の不足」は54.0%にのぼりました(EXIDEA調査 2022年4月 n=106)。業界を理解しないまま上位をなぞると、似た記事が量産される。この構図は、内製でも外注でも変わりません。まとめ直しから抜ける唯一の道は、前章の4型で「上位に載っていない情報」を最低1つ加えることです。
まとめ直しが起きる根っこは、たいてい時間とコストの制約です。1本あたりの単価が低く、納期が短いと、書き手はリサーチを削り、上位を写す方向に流れます。外注で類似コンテンツが量産される背景も、発注側が「安く速く」だけを求めた結果であることが少なくありません。ここを断つには、独自性を「あれば嬉しいオプション」ではなく「発注要件・工程の必須項目」に格上げする必要があります。一次データを1つ、独自の比較軸を1つ、と最低ラインを決めておけば、時間に追われても焼き直しには落ちません。独自性は根性で捻り出すものではなく、要件として最初に固定しておくものです。
NG2:AI出力をそのまま公開(人手のE-E-A-T付与が前提)
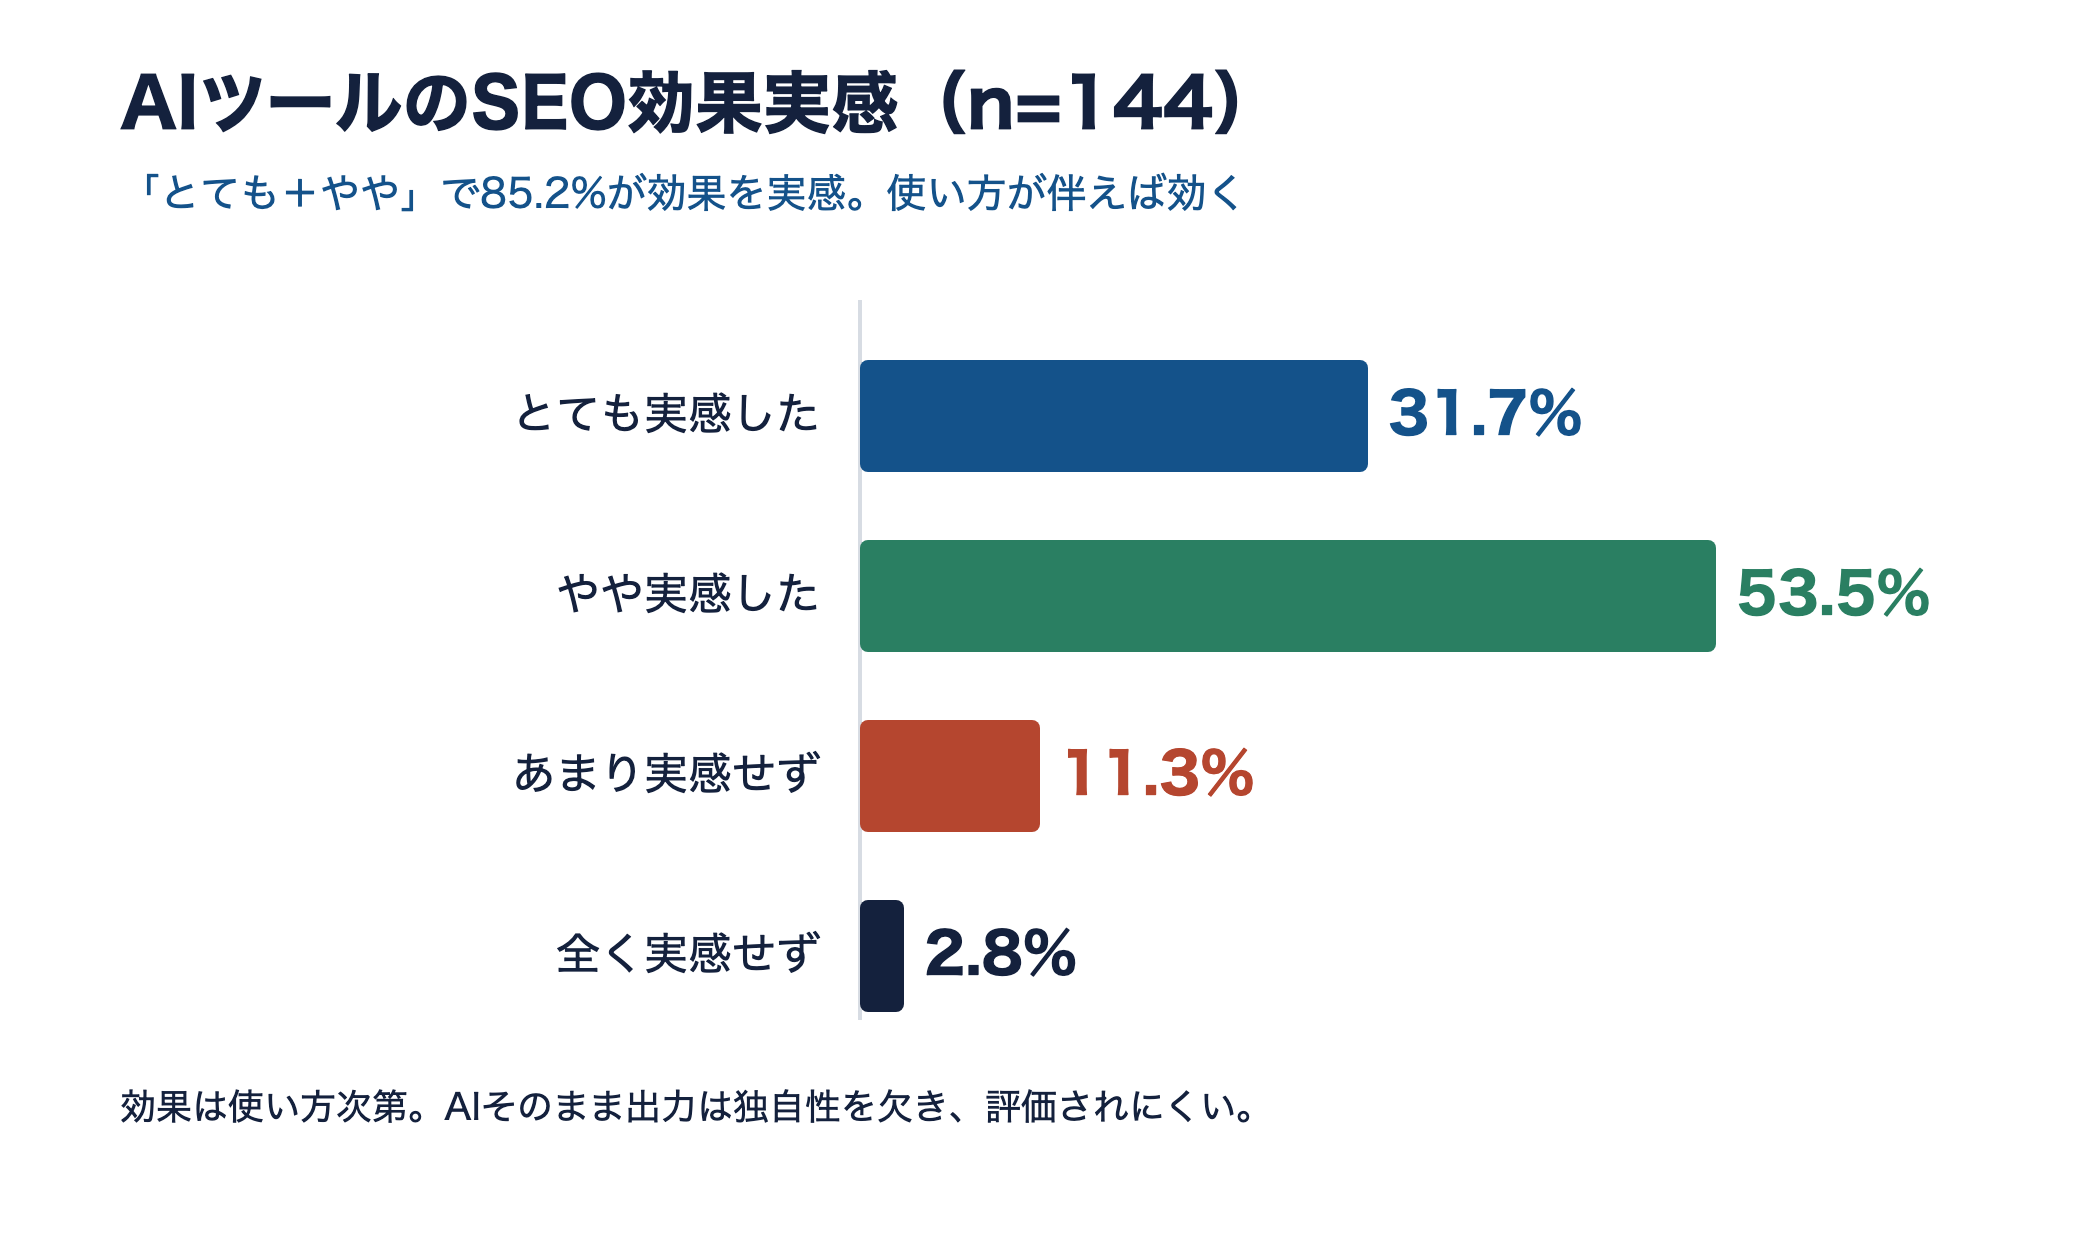
2つ目は、AIの出力をほぼそのまま公開する作り方です。生成AIをSEOに使った人の85.2%が効果を実感しています(とても31.7%+やや53.5%)。この数字はAIの有用性を示す一方で、AI活用がもはや当たり前になったことも意味します。みんなが同じツールで書けば、出力は互いに似てきます。落とし穴は、出力をそのまま出すと、学習データの平均に寄った没個性な文章になり、独自性がまるごと抜け落ちる点にあります。上位を平均化する焼き直しと、モデルの平均に寄せるAIそのまま出力は、「平均に近づく」という意味で同じ失敗の別バージョンです。SEO支援会社のLANYも、AIを使う場合でも人手によるE-E-A-Tの付与とファクトチェックが必須だと整理しています(LANY「AI SEO」)。正しい使い方は、AIに下書きと構成の高速化を任せ、一次データ・独自の切り口・実体験・事実確認という「独自性の付与」を人が担う分業です。AIの速度に、まとめ直しの中身を乗せてしまえば、失敗をより速く量産することになります。
もう1つ見落とされがちなのが、AIそのまま出力に潜む事実誤認です。生成AIは、もっともらしい嘘を自然な文章で書きます。出典を確認せずに公開すると、誤った数字や存在しない事例が、独自性のない文章に混ざって世に出ます。これはSEO評価を下げるだけでなく、読者の信頼を一度で失う致命傷になりかねません。だからこそ、AIを使う工程には必ず人手のファクトチェックを挟みます。数値は一次ソースまで遡って一致を確認し、固有名詞や事例は実在を確かめる。この検証こそが、E-E-A-Tの信頼性(Trust)を担保する作業であり、AI時代にむしろ人の価値が上がる部分です。
激安AI SEOは、AIで下書きと構成を高速化しつつ、一次情報の反映と人手のファクトチェックを工程に残しています。AIそのまま出力の没個性を避け、独自性を保ったまま量産できる設計です。
独自性を仕組み化する|チェックリストと型の運用
独自性を「書き手の気合い」に依存させると、担当が変わった瞬間に崩れます。属人化を避ける鍵は、独自性を工程とチェックリストに落とすこと。才能ではなく手順にすれば、複数人でも一定の水準を保てます。ここでは公開前のチェックリストと、型を担保した運用が成果につながった事例を示します。
公開前の独自性チェックリスト6項目
記事を公開する前に、次の6つを1本ごとに通します。1つでもNoが残るなら、それはまだ焼き直しの側にいるサインです。
- この記事にしかない一次データか実体験が、最低1つ入っているか。
- 比較表の「軸」が、既存記事の流用ではなく自社視点で組めているか。
- 検索意図に対し、上位となぞらない角度を1つ持てているか。
- 本文の数値すべてに、一次ソースへのリンクが付いているか。
- AIの下書きに、人手の検証と固有の視点を足したか。
- 見出しに固有名詞や数字が入り、抽象的な一般論になっていないか。
このリストの価値は、独自性の判断を個人の感覚から共有の基準へ移すところにあります。編集者はこの6項目で差し戻せばよく、ライターは書く前に何を仕込むかが分かる。外注する場合も、この6項目を発注要件に書き込めば、まとめ直し納品を入口で防げます。特に1番と2番は、上位をなぞっただけの記事が必ず引っかかる関門です。逆に言えば、この2つを毎回クリアできる工程さえ組めれば、独自性は個人技ではなく組織の再現可能な出力になります。
チェックリストは、AIを併用する現場でこそ効きます。AIに下書きを任せると、6項目のうち3番から6番は自動では埋まりません。人が意図的に、独自の角度を決め、一次ソースを当て、固有の視点を足し、見出しを具体化する。この4手をAI出力の後に必ず挟むと決めておけば、速度を保ったまま独自性が抜け落ちるのを防げます。リストを形骸化させないコツは、YesかNoで答えられる粒度に保つことです。「独自性はあるか」では曖昧すぎて誰も差し戻せません。「一次データが1つ以上あるか」なら、あるかないかで即断できます。判断を主観から機械的な確認へ寄せるほど、チェックは機能します。
型を担保した運用が成果に届く(セッション約20倍の事例)
仕組み化の効果は、数字にも表れます。ウィルゲートが支援したトシモリ薬局の事例では、型を担保した記事制作でセッションが約20倍に伸び、対策キーワードの7割超が10位以内に入りました。期間は約8か月です(ウィルゲート/トシモリ薬局 事例)。ここで見落とせないのは、成果が出るまで約8か月かかっている点です。独自性のある記事は、公開直後に爆発するものではなく、積み上げで効いてきます。評価される前に打ち切れば、せっかくの独自性も成果に届きません。この事例で効いたのは、単発の名記事ではなく「型を担保した」運用、つまり毎回同じ品質で独自性を担保する仕組みでした。独自性を属人化させず工程に固定したからこそ、本数を重ねても質が落ちず、8か月かけて面全体が持ち上がった。ここに、独自性を仕組み化する意味が凝縮されています。1本のホームランより、全打席で一定以上を出し続ける再現性のほうが、SEOでは効いてきます。焼き直し記事と独自性を設計した記事は、公開直後は見分けがつきにくくても、数か月後の順位で差が開きます。両者が具体的にどう違うのかを、最後に1枚の表で対比します。
| 観点 | 上位まとめ直し記事 | 独自性を設計した記事 |
|---|---|---|
| 情報源 | 上位数本の二次情報のみ | 一次ソース+自社データを併用 |
| 比較表 | 他社の表を流用 | 自作の比較軸で新規作成 |
| 切り口 | 検索意図をなぞるだけ | 局面・読者を絞った独自角度 |
| E-E-A-T | 経験の記述なし | 実体験・取材で経験を明示 |
| AIの使い方 | 出力をそのまま公開 | 下書きに人手で検証・味付け |
| Google評価 | スケーリング不正扱いのリスク | 独自価値として評価されやすい |
この表を眺めると、独自性が単一の魔法ではなく、情報源・比較表・切り口・経験・AIの使い方という複数の工程の積み重ねだと分かります。1か所だけ独自にしても、他が焼き直しのままなら全体は平均に近づく。逆に、6つの観点を1つずつ独自側へ倒していけば、記事はゆっくり、しかし確実に他社と離れていきます。差別化とは、どこか1点で劇的に勝つことではなく、複数の小さな差を積んで総合点で抜けることです。だから、才能のある一人に頼るより、工程として全員が同じ基準で積める体制のほうが、長い目で見て強くなります。
独自性は、設計とチェックの手順に落とせば再現できます。まずは次の1本で、上位に載っていない一次データか実体験を1つだけ足し、比較表の軸を自社視点で組み直すところから始めれば十分です。それだけで、その記事はもう「11本目の要約」ではなくなります。4つの型を工程に組み込み、6項目のチェックを毎回通す。この積み重ねが、焼き直しから抜け出す最短ルートになります。
激安AI SEOは、独自の切り口・一次データ・独自比較表・実体験という4つの型を工程に組み込み、公開前の独自性チェックまで含めて低コストで回します。焼き直しにならない記事づくりを、まず無料で相談できます。