目次
一次情報が効く理由|「経験」と独自性がE-E-A-Tを底上げする
「SEO記事 一次情報 集め方」で検索して上位を開くと、どこも「集め方5選」に近い構成で並んでいます。書いてあることは間違っていません。ただ、集め方を眺めても記事の順位は動かない。動くのは、拾った数字を疑い、原典まで遡り、記事に出典付きで載せきったときです。ここで一度、外注の現実を数字で見ておきます。記事制作を外注したBtoB企業のうち、発注で失敗した経験がある企業は82.1%にのぼりました(何度もある28.3%+ややある53.8%)。株式会社EXIDEAが2022年4月に実施した106名調査の数字です(EXIDEA調査リリース/PR TIMES)。失敗理由の1位は「自社が属する業界への知見・理解がなかった」54.0%。裏を返せば、独自の中身を持てるかどうかが成否を分けています。その中身の源が一次情報です。
一次情報とは、発信の主体そのものが出したデータや体験を指します。企業の公式発表、官公庁の統計、自分で取った取材やアンケート、実際に手を動かした実験。これらは他社が簡単には再現できません。だから記事に固有の重みが生まれ、Googleが重視するE-E-A-Tのうち、AIには出せない「経験(Experience)」を直接示せます。逆に、他社のまとめ記事を要約し直しただけの二次情報は、元ネタが同じである以上、検索結果のなかで横並びになります。順位を分けたいなら、まず自分の記事にしか載っていない事実を1つでも増やす。これが出発点です。
一次情報と二次情報の違い|定義・具体例・SEO評価で整理する
言葉の定義でつまずくと、後の検証がぶれます。一次情報と二次情報を、定義・具体例・独自性・評価のされ方まで並べて整理します。ポイントは「誰が最初に出したか」。同じ数字でも、発信主体の公式ページに載っていれば一次、それを紹介したブログは二次です。記事の信頼性は、この一次まで遡れているかで決まります。
| 観点 | 一次情報 | 二次情報 |
|---|---|---|
| 定義 | 発信主体そのものが出したデータ・体験・実測 | 一次情報を第三者がまとめ・解釈したもの |
| 具体例 | 公式IR、官公庁統計、自社アンケート、取材、実験 | まとめ記事、要約ブログ、他社の解説 |
| 独自性 | 高い。他社が再現しにくい | 低い。同じ元ネタが横並びになる |
| 検索・AIでの評価 | 経験・信頼性でE-E-A-Tを底上げ。引用されやすい | 焼き直し判定を受けやすい |
| 主なリスク | 収集コストと検証の手間がかかる | 孫引きで誤情報が伝播しやすい |
この表で強調したいのは、二次情報が悪だという話ではない点です。全体像をつかむには二次情報が近道になります。問題は、そこで止まって二次情報の数字をそのまま載せること。まとめ記事が引いた数字が、実は古い版だったり、条件を落として丸められていたりする例は珍しくありません。だから二次情報は入口として使い、必ず発信主体の一次ページまで確認しにいく。この一手間が、記事の信頼性と、後述するAIからの引かれやすさに直結します。
AI検索時代に一次情報が引用される|プレスリリースが引用2位という事実
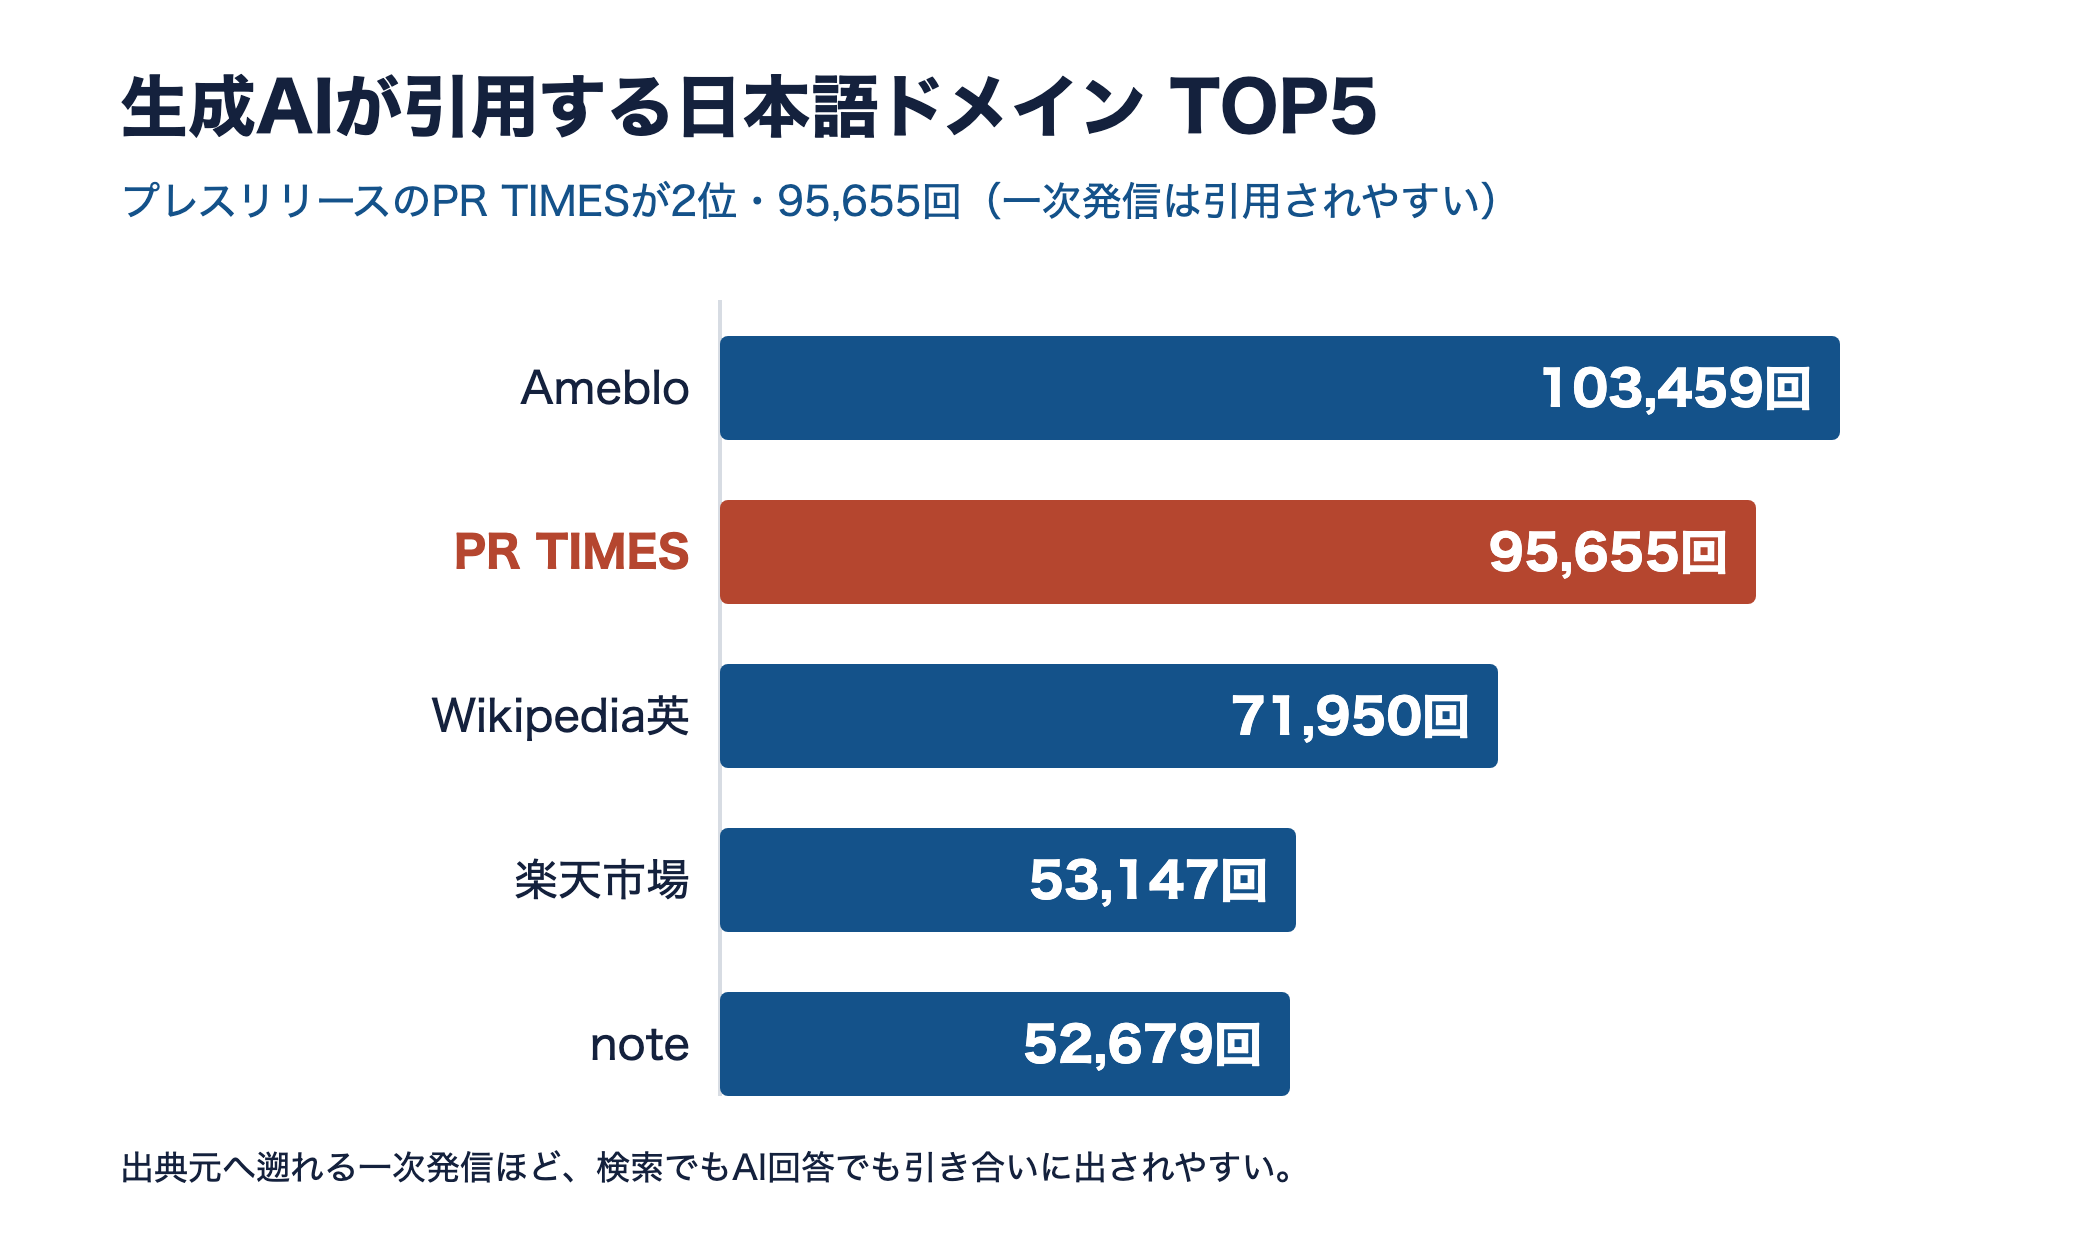
一次情報が効く理由は、検索順位だけの話ではなくなりました。生成AIの回答が情報源をどのドメインから引いているかを調べたAhrefsのデータでは、日本語での引用回数の上位に、プレスリリース配信のPR TIMESが95,655回で2位に入っています。1位はAmebloの103,459回、3位はWikipedia英語版の71,950回でした。ここで見るべきは、上位に「発信元へ遡れる場所」が並ぶことです。プレスリリースは調査主体と発表日が明示され、誰が出した数字かをたどれます。AIは根拠をたどれる情報を選びやすく、その性質が引用回数に表れています。
つまり、記事に一次情報を載せる意味は二重です。1つは読者に対する説得力。もう1つは、検索エンジンと生成AIの双方に「この記事は根拠をたどれる」と示すこと。焼き直しの二次情報だけで組んだ記事は、AIの回答に引かれる場面でも不利になります。逆に、原典まで遡って数字を置いた記事は、検索でもAI回答でも引き合いに出される回数が増えます。順位とAI引用の両方を取りにいくなら、一次情報の有無は後回しにできない条件です。
一次情報を毎回集めて検証するのは骨が折れます。激安AI SEOは、一次情報のリサーチと出典の検証を標準工程に組み込み、独自性のある記事を低コストで量産します。
一次情報の集め方5経路|公式・PR TIMES・官公庁統計・調査レポート・専門家
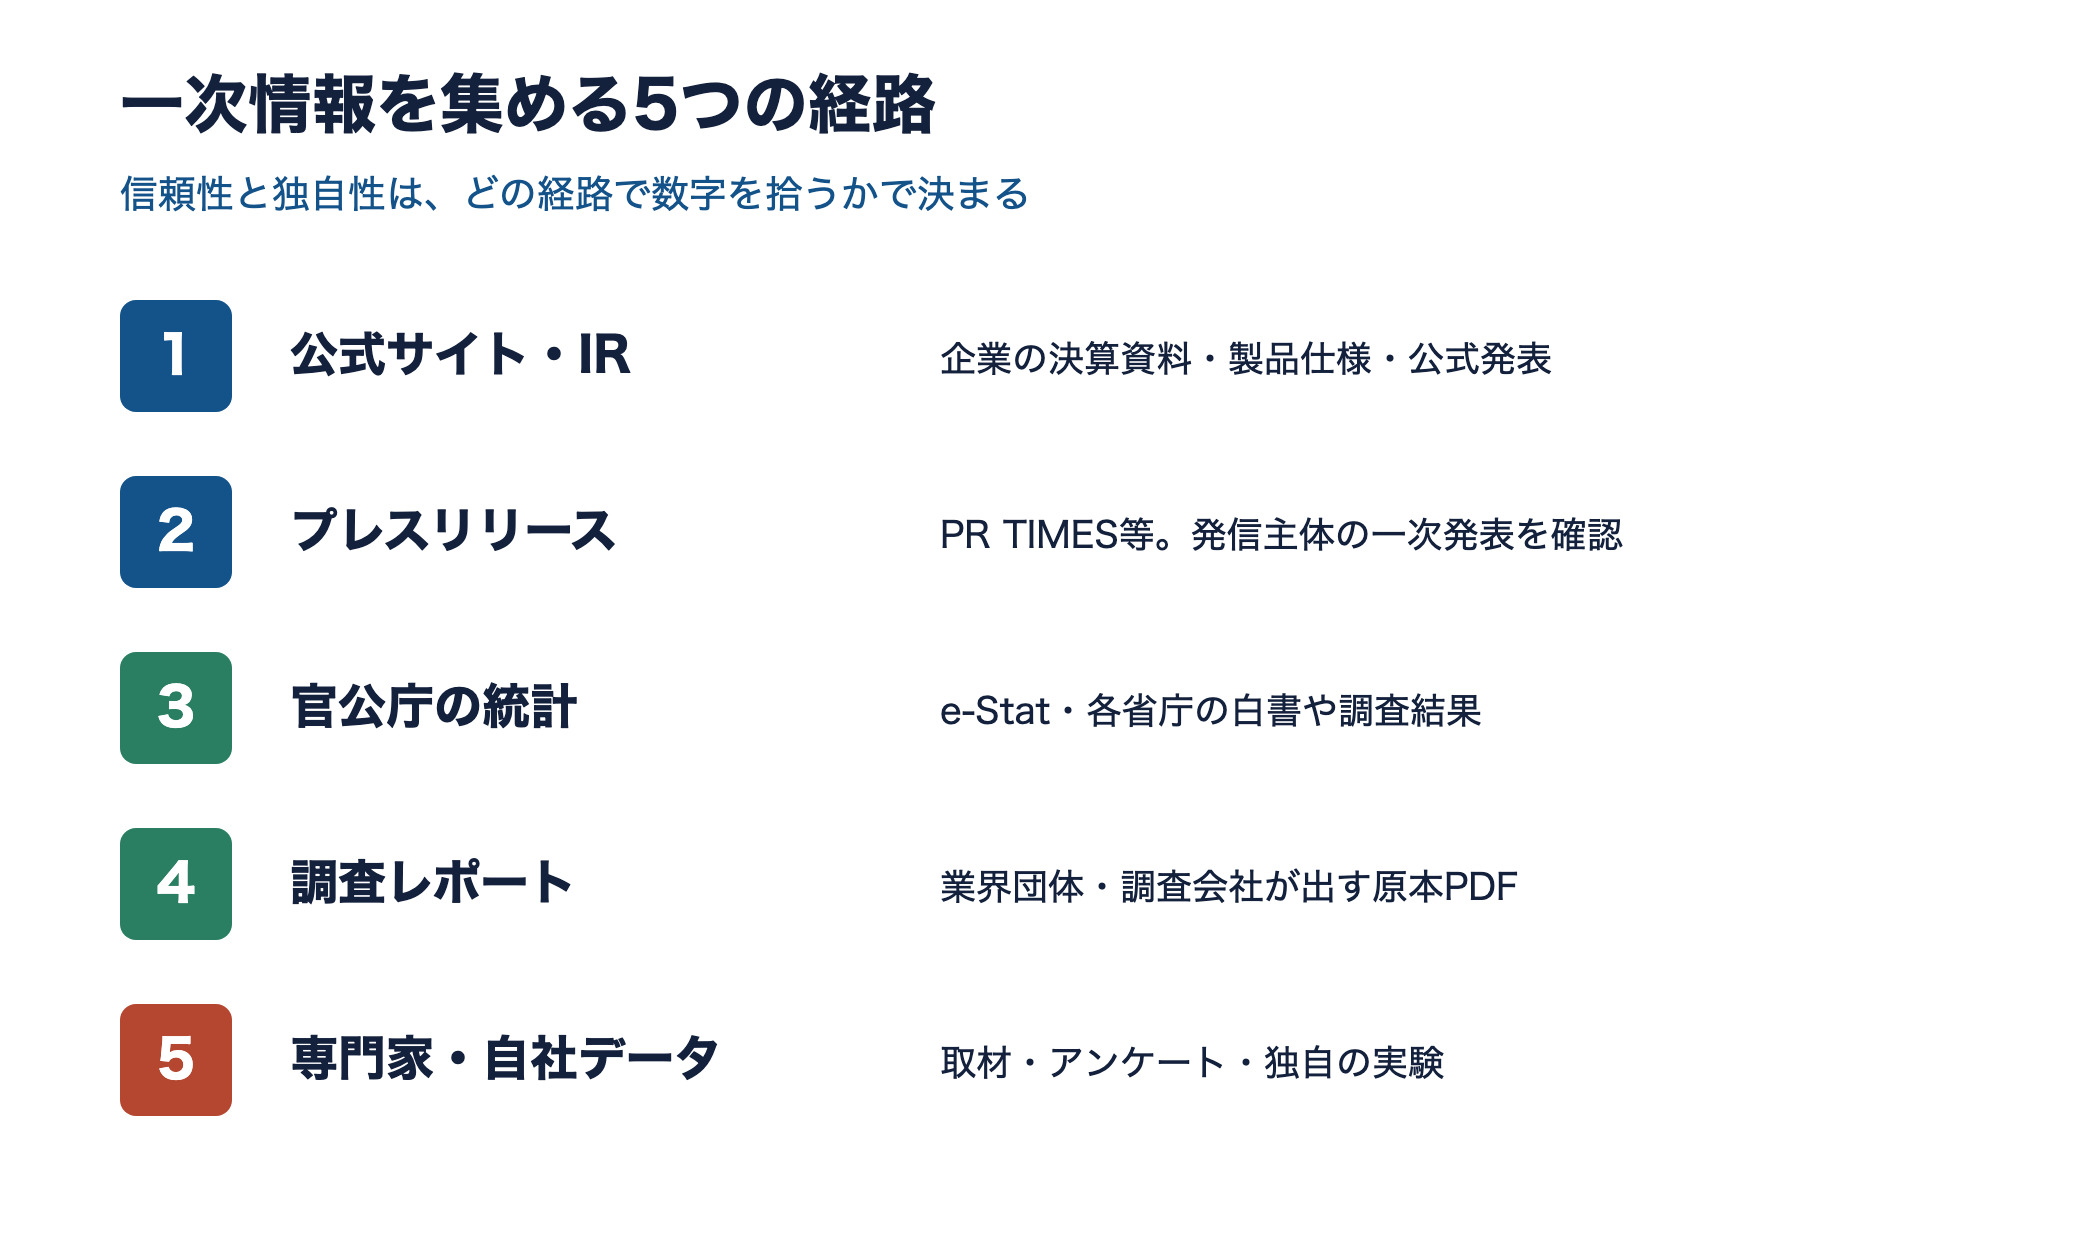
一次情報はやみくもに探すと時間だけ溶けます。実務では、取りにいく先を5つの経路に分けておくと迷いません。公式サイト・IR、プレスリリース、官公庁の統計、調査レポート、専門家取材と自社データ。経路ごとに、得られる独自性の高さと、取得にかかる手間が違います。まず全体像を1枚で押さえてから、それぞれの勘所を見ていきます。
公式サイト・IR|発表主体の一次データを取りにいく
最も手軽で確実なのが、企業や団体の公式サイトです。製品の仕様、料金、決算資料(IR)、公式のお知らせは、その主体が責任を持って出した一次情報です。他社記事が「A社の売上は約○億円」と書いていても、まずはA社のIRページで元の数字と年度を確かめる。ここで多いのが、要約段階で単位や期間が変わっているケースです。四半期の数字を通年のように扱っていたり、前年比の基準がずれていたり。公式まで一度触れておけば、この種のずれを持ち込まずに済みます。製品比較の記事なら、各社の公式仕様ページを並べて確認するだけでも、二次情報だけの競合と差がつきます。公式サイトを見るときは、更新日と改定履歴も一緒に控えておくのが実務のコツです。料金や仕様は静かに変わることがあり、古い数字を引いたまま記事を出すと、公開直後に事実誤認になりかねません。IR資料なら、サマリーの見出し数字だけでなく、脚注に書かれた集計の前提(対象期間・為替・非継続事業の扱い)まで目を通すと、要約記事が落としがちな条件を拾えます。一次にあたる価値は、正しい数字を得ることだけでなく、その数字が成り立つ条件ごと理解できる点にあります。
プレスリリース|発信元をたどれる調査リリースを使う
最新の調査数値や市場トレンドを引くなら、PR TIMESをはじめとするプレスリリースが速くて強い。企業が自ら調査を公表しているため、調査主体・実施時期・サンプル数がひとまとめで示されます。この記事で使っているEXIDEAの外注失敗82.1%も、Ahrefsの引用ドメインの数字も、出どころはプレスリリースです。使うときのコツは、リリース本文に書かれた調査概要(n数・期間・対象)を必ず一緒に控えること。数字だけを抜くと、後で条件を聞かれて答えられません。プレスリリースは一次発信でありながら宣伝も兼ねる場なので、後述する発信元の立場の点検とセットで扱います。
官公庁の統計|e-Stat・白書で公的な裏づけを得る
母集団が大きく、中立性の高い数字がほしいときは、官公庁の統計が土台になります。政府統計のポータルe-Statや、各省庁が出す白書・調査結果は、公的な一次情報です。たとえば生成AIの普及を語るなら、総務省の令和7年版情報通信白書で、生成AIの活用方針を定めている企業が49.7%というデータを引けます(総務省 令和7年版情報通信白書)。官公庁データの弱点は、更新が年次で最新の細かい動きに弱いこと、そして表の読み取りに手間がかかることです。だからこそ正確に引ければ、記事の信頼性は一段上がります。数字は必ず原本の表まで開き、注釈と調査年をあわせて確認します。e-Statを使う場合は、キーワードで統計表を絞り込み、ダウンロードした表の定義ページで「どの調査の・いつの・どの区分の数字か」を確認してから引くと、取り違えが減ります。白書はグラフだけを見て数字を推測せず、必ず本文の記述と数表の値を突き合わせます。公的統計は誰でも同じ原本にアクセスできるぶん、正しく引いたか・条件まで添えたかで記事の丁寧さがそのまま出ます。
調査レポート・業界団体|原本PDFまで遡る
業界固有の指標や定点データは、業界団体や調査会社のレポートが詳しい。ここで守りたいのは、要約記事ではなく原本PDFまで遡ることです。調査会社のレポートはニュース記事で断片的に紹介されがちで、その断片だけを引くと、調査設計や但し書きを見落とします。原本にあたると、対象者の属性、質問文、集計方法まで確認でき、記事での言い切り方を適切に調整できます。有料レポートでも、要旨やプレスリリース版が無料公開されていることが多く、まずはそこから一次にあたる導線を探します。原本の発行元と発行年を記事に明記できれば、読者もAIも根拠をたどれます。断片記事から原本にたどり着けないときは、その数字を「出典不明のまま使わない」判断も含めて検討します。無理に引くより、確実にたどれる別の一次データに差し替えるほうが、記事全体の信頼を守れます。業界団体のレポートは、定義や集計対象が団体ごとに違うことも多いので、複数年で比較するなら同一シリーズの同一定義かどうかまで確認してから並べます。
専門家取材・自社データ|再現不能な独自性をつくる
ここまでの4経路は他社も到達できます。決定的な差は、自分にしか作れない一次情報から生まれます。専門家への取材、現場での実測、自社サービスの利用データ、独自のアンケート。これらは他社が再現できないため、独自性が最も高くなります。取材は、一次発信をそのまま引き出せる手段です。数十人規模のアンケートでも、設問設計と集計を丁寧にやれば、記事に固有の数字を持ち込めます。手間はかかりますが、この経路を1本でも記事に組み込めると、二次情報の焼き直しからは完全に抜け出せます。次の表で、5経路の独自性・取得コスト・使いどころを俯瞰します。
| 経路 | 主な取得先 | 独自性 | 取得コスト | 向く使いどころ |
|---|---|---|---|---|
| 公式サイト・IR | 決算/製品仕様/公式発表 | 中 | 低 | 事実確認・スペックの一次確認 |
| プレスリリース | PR TIMES等の調査リリース | 中 | 低 | 最新の調査数値・市場動向 |
| 官公庁の統計 | e-Stat・各省庁の白書 | 中 | 中 | 公的な裏づけ・大きな母集団 |
| 調査レポート | 業界団体・調査会社の原本PDF | 中〜高 | 中 | 業界固有の指標・定点データ |
| 専門家・自社データ | 取材・アンケート・独自実験 | 高 | 高 | 再現不能な独自性・体験の付与 |
現実的には、この5経路を単独で使うより、組み合わせるのが効きます。公式とプレスリリースで骨格の数字をそろえ、官公庁統計で公的な裏づけを足し、最後に自社データか取材を1本差し込む。手軽な経路で土台を固め、独自性の高い経路で差別化する、という配分です。1記事にすべてを詰める必要はありません。テーマに合う経路を2〜3本選べば十分に濃くなります。
5経路を毎回たどるのは、社内リソースだと重い作業です。激安AI SEOなら、公式・統計・調査レポートの横断リサーチを高速化し、人の手で裏取りまで済ませて納品します。
拾った数字を疑う|一次情報の検証3ステップ
集めただけで載せると、事故が起きます。よくあるのは、他社記事が引いた数字を孫引きし、そのまま自分の記事に転記してしまうパターン。元をたどると数字が違った、出典URLが切れていた、という話は現場で頻発します。だから集める工程と載せる工程の間に、検証を1枚はさみます。URLの実在、原典との照合、発信元の立場。この3つを順に通した数字だけを、本文に置きます。
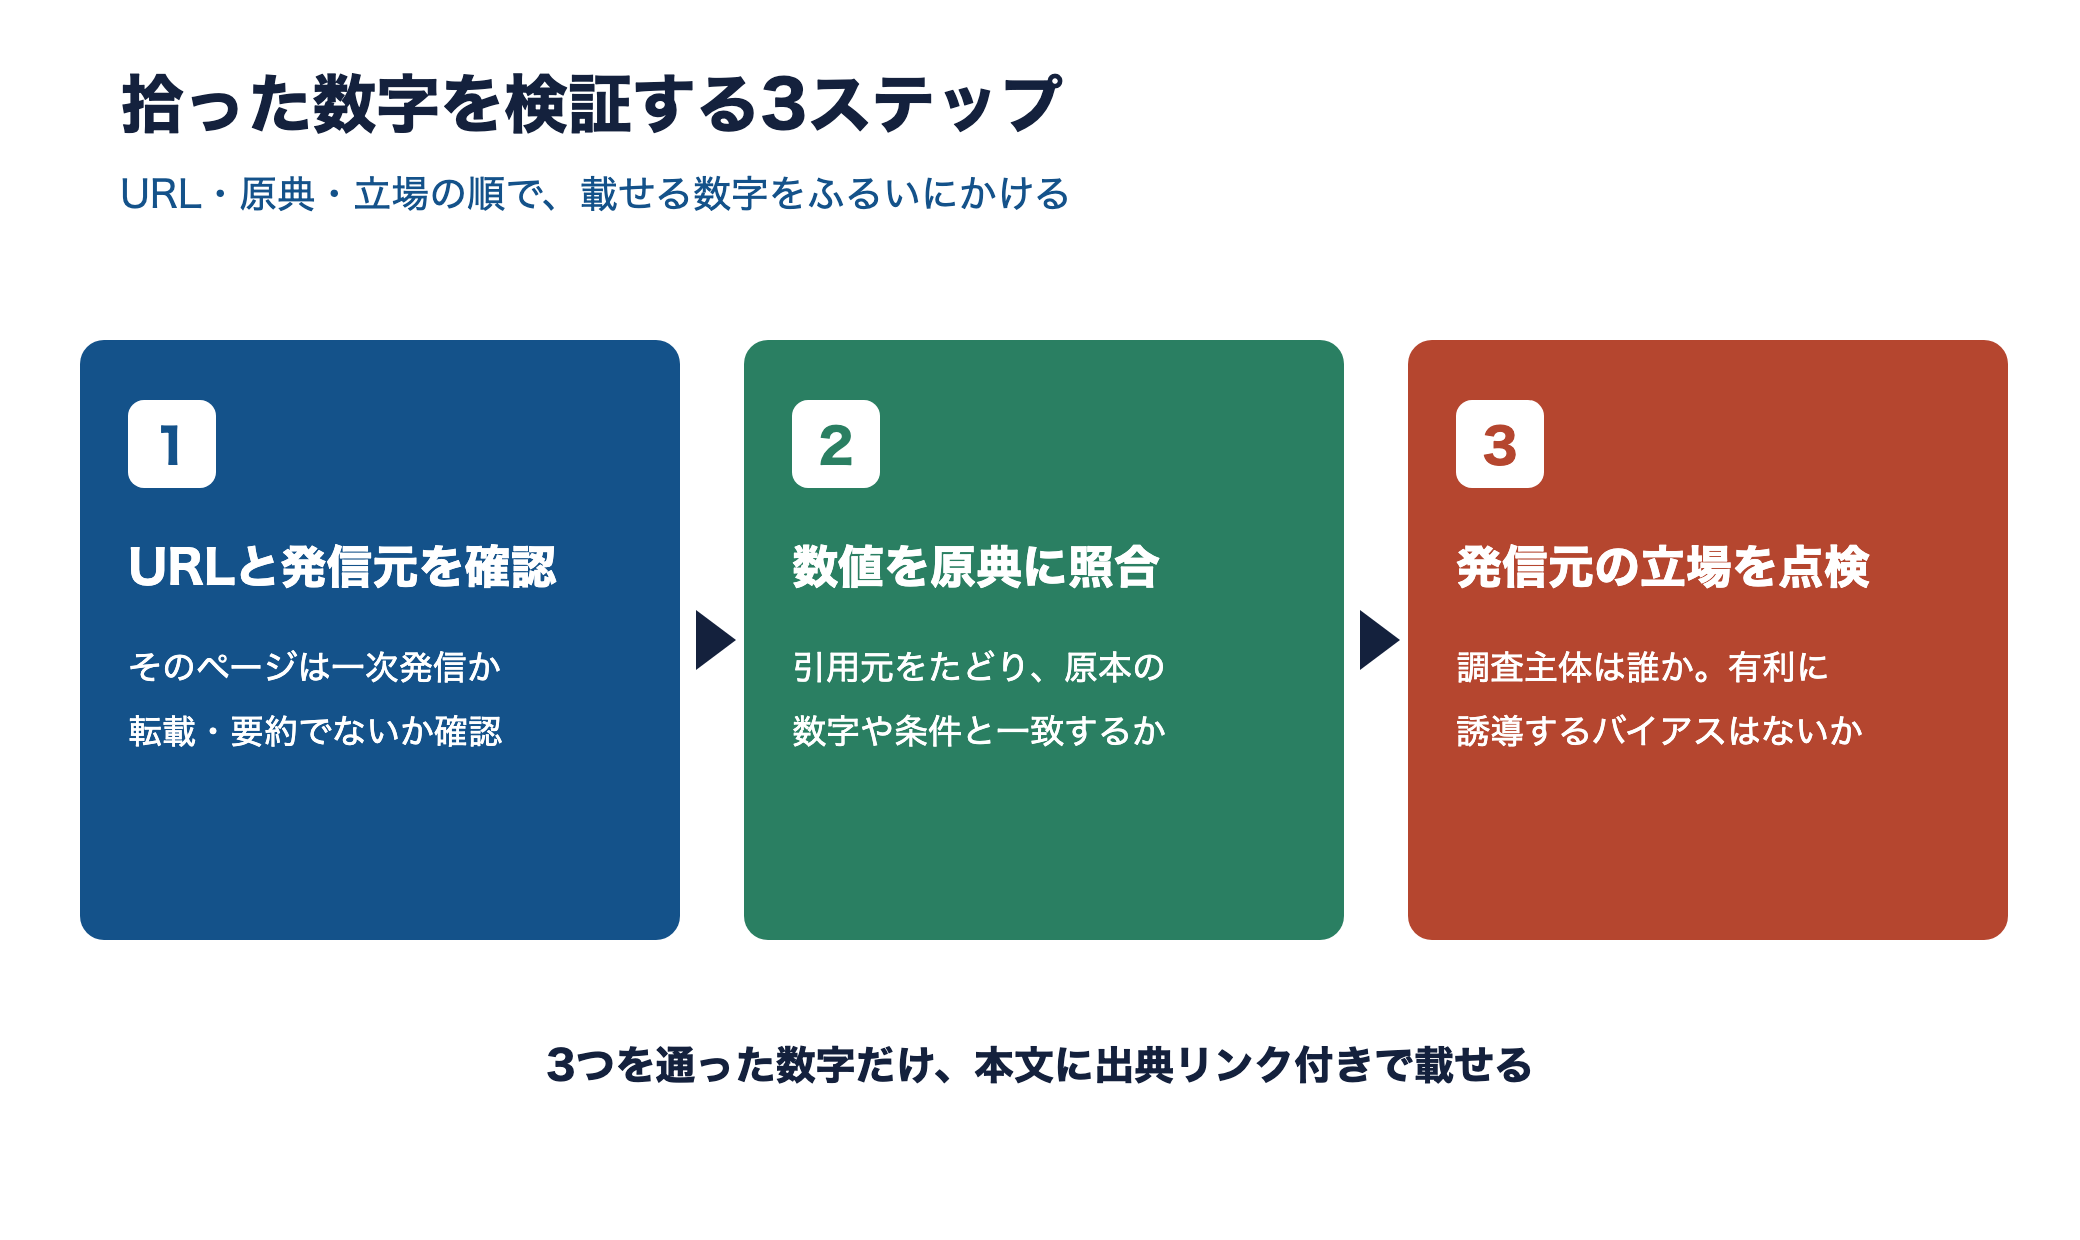
ステップ1|URLの実在と発信元の一次性を確認する
最初にやるのは、数字が載っているURLを実際に開くことです。当たり前に聞こえますが、AIに下書きを任せた場合ほど、この確認が抜けます。生成された文章にそれらしい出典が付いていても、URLが存在しない、あるいは別ページを指していることがあるからです。開いたら、そのページが一次発信かを見ます。調査主体が自ら公開したページなのか、それを紹介した二次のまとめなのか。まとめだった場合は、そこに張られた元リンクをたどって発信元まで進みます。ここで一次にたどり着けない数字は、記事に載せない判断も選択肢に入れます。実務では、数字を見つけた時点で本文とは別に「数値・単位・調査年・n数・原典URL」をメモに控えておくと、この確認が一度で済みます。あとから出典を探し直す二度手間がなくなり、公開前のチェックも速くなります。特にAIに下書きを作らせる運用では、生成された数字を鵜呑みにせず、この確認を通した数字だけを本文に残す、という一線を最初に決めておくと事故が起きません。
ステップ2|数値を原典に照合し孫引きを排除する
URLを開けたら、次は数字そのものの照合です。本文に書こうとしている数値・単位・調査年・サンプル数が、原典の表記と完全に一致するかを1つずつ突き合わせます。孫引きで起きる典型的なずれは3種類あります。丸め(54.0%を「約5割」に変える)、期間の取り違え、母集団の混同です。たとえばEXIDEAの数字なら、82.1%という合計だけでなく、内訳の28.3%と53.8%、そしてn=106という条件までセットで押さえておく。原典に一致しない数字は、たとえ結論に都合がよくても使いません。照合の手間を惜しむと、指摘一発で記事全体の信頼が崩れます。
ステップ3|発信元のポジション性(利害)を点検する
数字が実在し、原典とも一致していても、まだ一段あります。その数字を出した主体に、どんな利害があるかの点検です。自社サービスに有利な結論へ誘導する調査設計になっていないか、対象者が偏っていないか、質問文が答えを誘っていないか。プレスリリース由来の調査は特に、宣伝目的が混じります。悪用だと決めつける必要はありませんが、立場を知ったうえで引くのと、知らずに引くのとでは記事の慎重さが変わります。中立性の高い官公庁データと、事業者の自社調査を、同じ重みで扱わない。この感覚が、読者からの信頼を守ります。
記事への落とし込み|数値ごとの出典リンクと図解でE-E-A-Tを可視化する
検証を通った一次情報も、載せ方を間違えると効きません。よく見るのが、段落の最後に参考リンクを1本だけまとめて置く形です。これだと、どの数字がどの出典に対応するのか読者にもAIにも伝わりません。載せ方の基本は、数値ごとに、その数字を出した原典へリンクを張ること。そして、重要な一次データは文字で流さず、図解に落として1つの視覚として見せることです。NG例とOK例を並べて整理します。
| 観点 | NG(評価されにくい) | OK(評価される) |
|---|---|---|
| 出典の粒度 | 段落末にまとめて1本リンク | 数値ごとに原典へリンク |
| 引用元 | まとめ記事を孫引き | 発信主体の一次ページ |
| 数字の扱い | 「約8割」と丸める | 82.1%(n=106)と条件を明記 |
| 見せ方 | 本文に数字を羅列 | 図解+キャプションに出典を添える |
数値ごとに原典リンクを張る|まとめ引用をやめる
リンクの張り方は、そのまま記事の姿勢を映します。数値が出てくるその場で、対応する原典へリンクする。読者は気になった数字をすぐ確かめられ、生成AIは数字と根拠の対応をたどれます。このとき、リンク先は必ず一次まで到達したページにします。まとめ記事に張ってしまうと、そのまとめが消えたり数字を書き換えたりした瞬間に、根拠ごと崩れます。合わせて、調査年とサンプル数を本文に一言添えると、数字の鮮度と規模が伝わり、古いデータを使っている競合との差になります。手間に見えて、これが独自性を「たどれる独自性」に変えます。
一次データは図解する|数字と単位を1つの視覚に落とす
強い一次データほど、文章に埋めると流し読みされます。棒グラフや簡単な図に起こすと、数字が記憶に残り、キャプションに出典を添えることで信頼性も同時に伝わります。図解では、数値と単位を1つのまとまりで見せ、調査年・サンプル数・出典元を必ず添えるのが鉄則です。派手な装飾は不要で、伝えたい1つの比較が一目で分かれば十分です。この記事の3つのデータ図も、色数を抑え、数字と出典だけを載せています。図は独自性を可視化する手段であり、同時にAIが数字の文脈を読み取る手がかりにもなります。図解にするときも、元の数字を丸めたり、印象を強めるために軸を切ったりしないのが原則です。見せ方で誇張した図は、原典と突き合わせられた瞬間に信頼を失います。数字はそのまま、単位と出典を添えて正直に置く。その素直さが、かえって読者にもAIにも「この記事はたどれる」という安心を与えます。
数値ごとの出典リンクと図解までやり切るのは、記事本数が増えるほど負担になります。激安AI SEOは、検証済みの一次データと図解をセットで記事に組み込みます。
一次情報リサーチを型で回す|AI活用と代行という選択肢
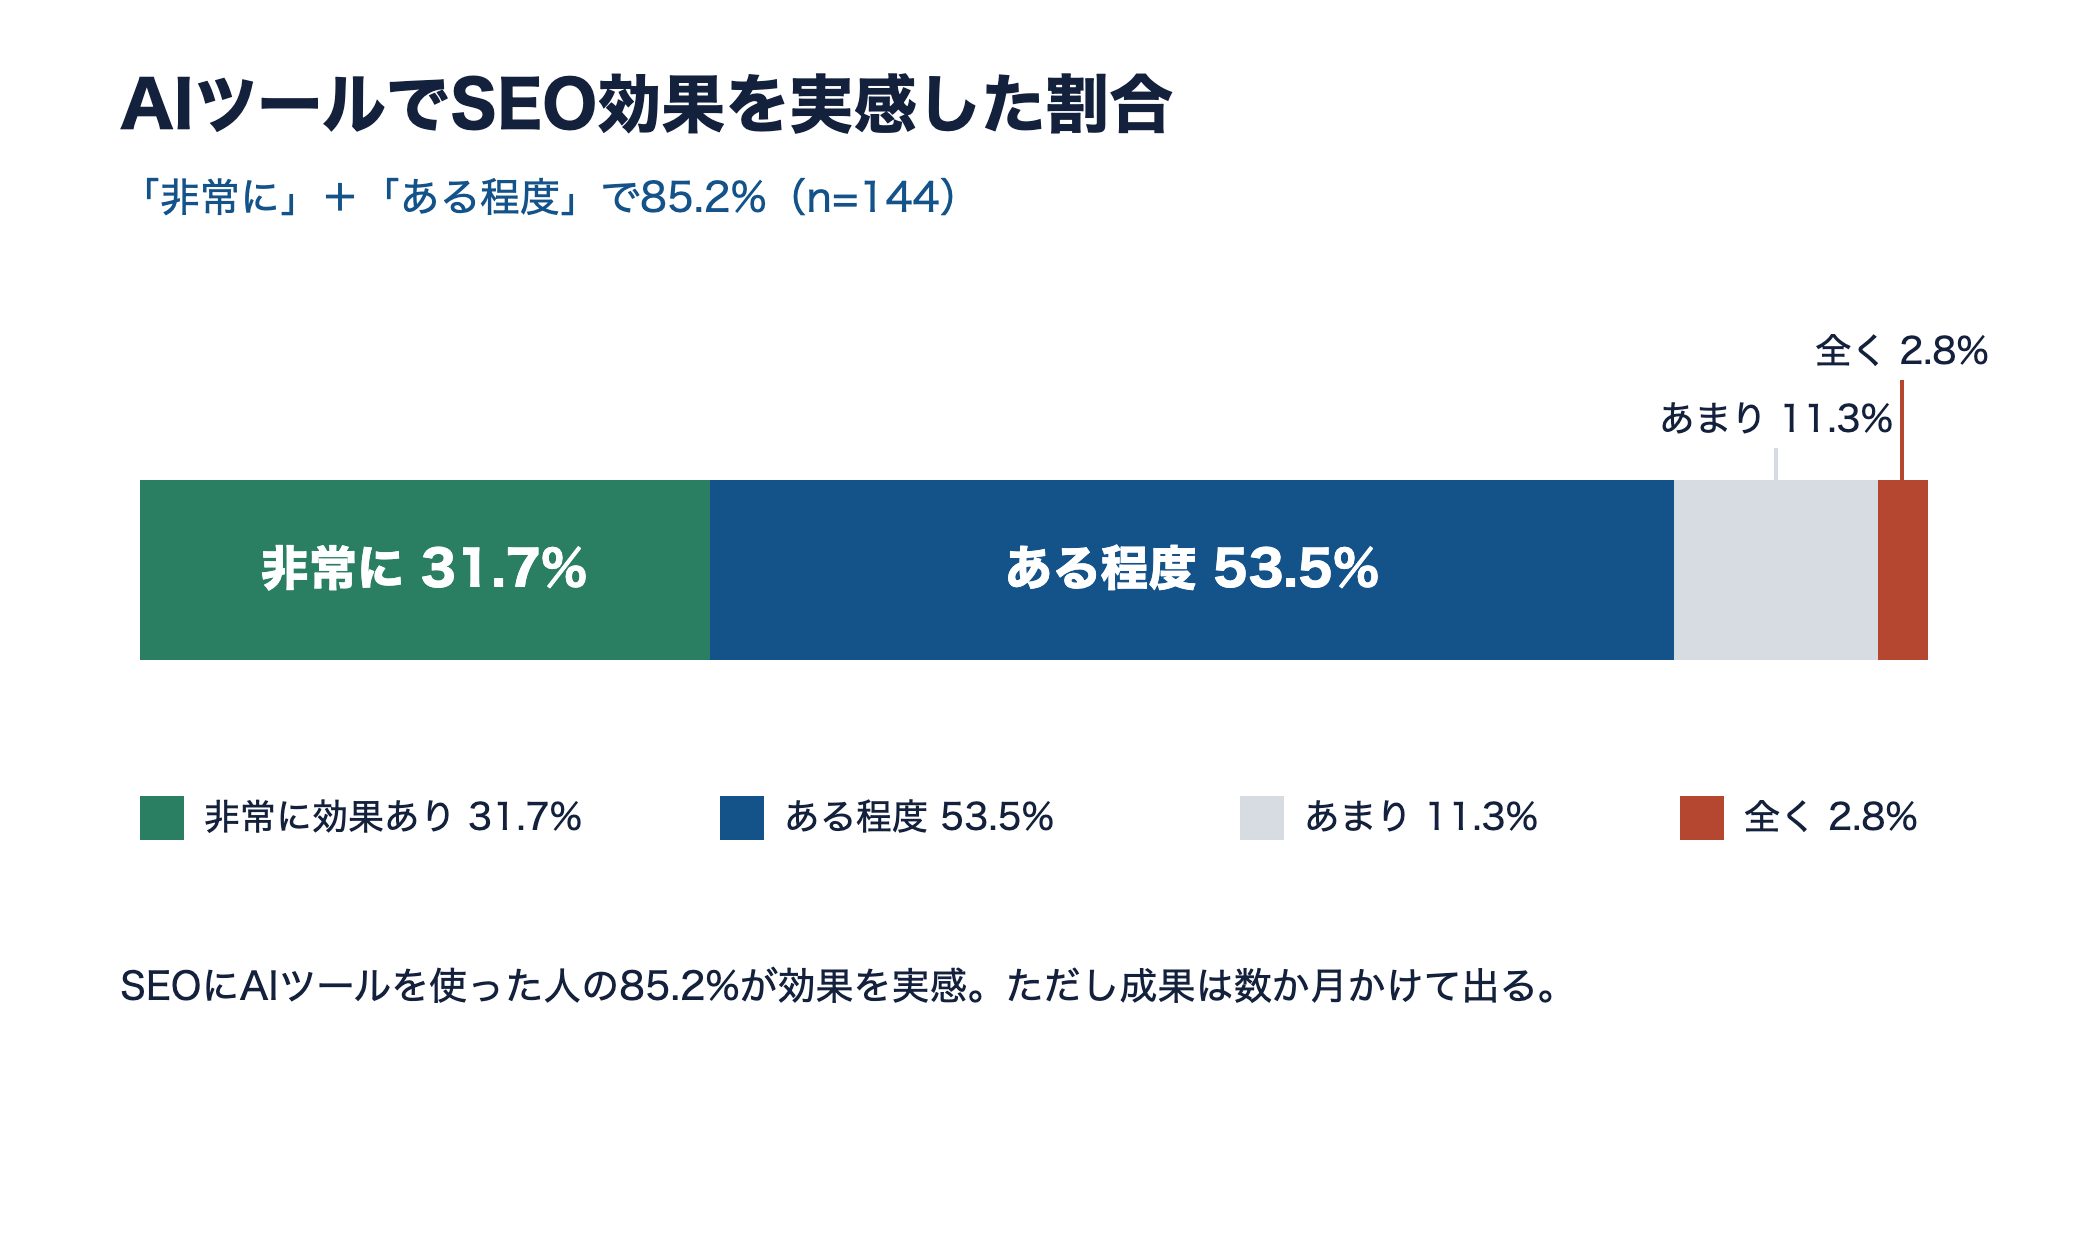
ここまでの型は、探す・検証する・記事化するの3工程に整理できます。効果は分かっていても、1本ごとに全部を回すと時間が足りない。そこで現実的なのが、AIで速度を出しつつ、検証と味付けを人が担う分業です。効果はデータでも裏づいています。AIツールをSEOに使った人の85.2%が効果を実感しました(とても31.7%+やや53.5%)。ランクエストとsyncADによる144名調査の数字です。
AIの効果はデータで裏づく、ただし短期決戦ではない
企業側の下地も整ってきました。総務省の令和7年版情報通信白書では、生成AIの活用方針を定めている企業が49.7%に達しています。実成果の例もあります。トシモリ薬局の事例では、AIを活用した記事支援でセッションが約20倍に伸び、期間は約8か月でした(ウィルゲート/トシモリ薬局 事例)。ここで見落とせないのは、成果が出るまで約8か月かかっている点です。AIを使ってもSEOは短期決戦ではありません。一次情報を集め、検証し、記事化する型を、数か月にわたって回し続けた先に成果が出ます。効果実感の高さは、正しく回せば効くという意味であって、放り込めば上がるという意味ではありません。
AIだけでは足りない|人手のE-E-A-Tとファクトチェックが前提
Googleは、コンテンツを制作手段ではなく品質で評価する立場を公式に示しています。AI生成であること自体を問題視せず、独自性と有用性を重視する方針です(Google 検索セントラル AIコンテンツの方針)。裏を返せば、一次情報も検証もないAI任せの記事は評価されません。SEO支援会社のLANYも、AIを使う場合でも人手によるE-E-A-Tの付与と公開前のファクトチェックが必須だと整理しています(LANY「AI SEO」)。良いAI活用とは、探す工程と下書きをAIで速め、原典照合と発信元の点検という検証を人が担う分業です。この検証を省いた瞬間、AIは二次情報の焼き直しを高速で量産する装置に変わります。
自分でやるにせよ任せるにせよ、判断軸は1つです。探す・検証する・記事化するの3工程が、工程として組み込まれているか。まずは手元の1記事で、数字が出てくるたびに原典まで遡り、数値ごとに出典を張り直すところから始めれば、独自性のある記事の手触りがつかめます。そのうえで本数を増やしたくなったら、この型を標準工程に持つ相手へ渡す。一次情報を軸に据えた記事づくりが、検索とAIの両方で選ばれる最短ルートになります。
激安AI SEOは、一次情報のリサーチ・原典照合・図解までを標準工程に組み込み、AIの速度と人手の検証を両立させた記事を、格安の水準で提供します。まず無料で相性を診断できます。