目次
AIは本文を読む前に「意味の構造」を解釈している|引用の土台は機械可読性
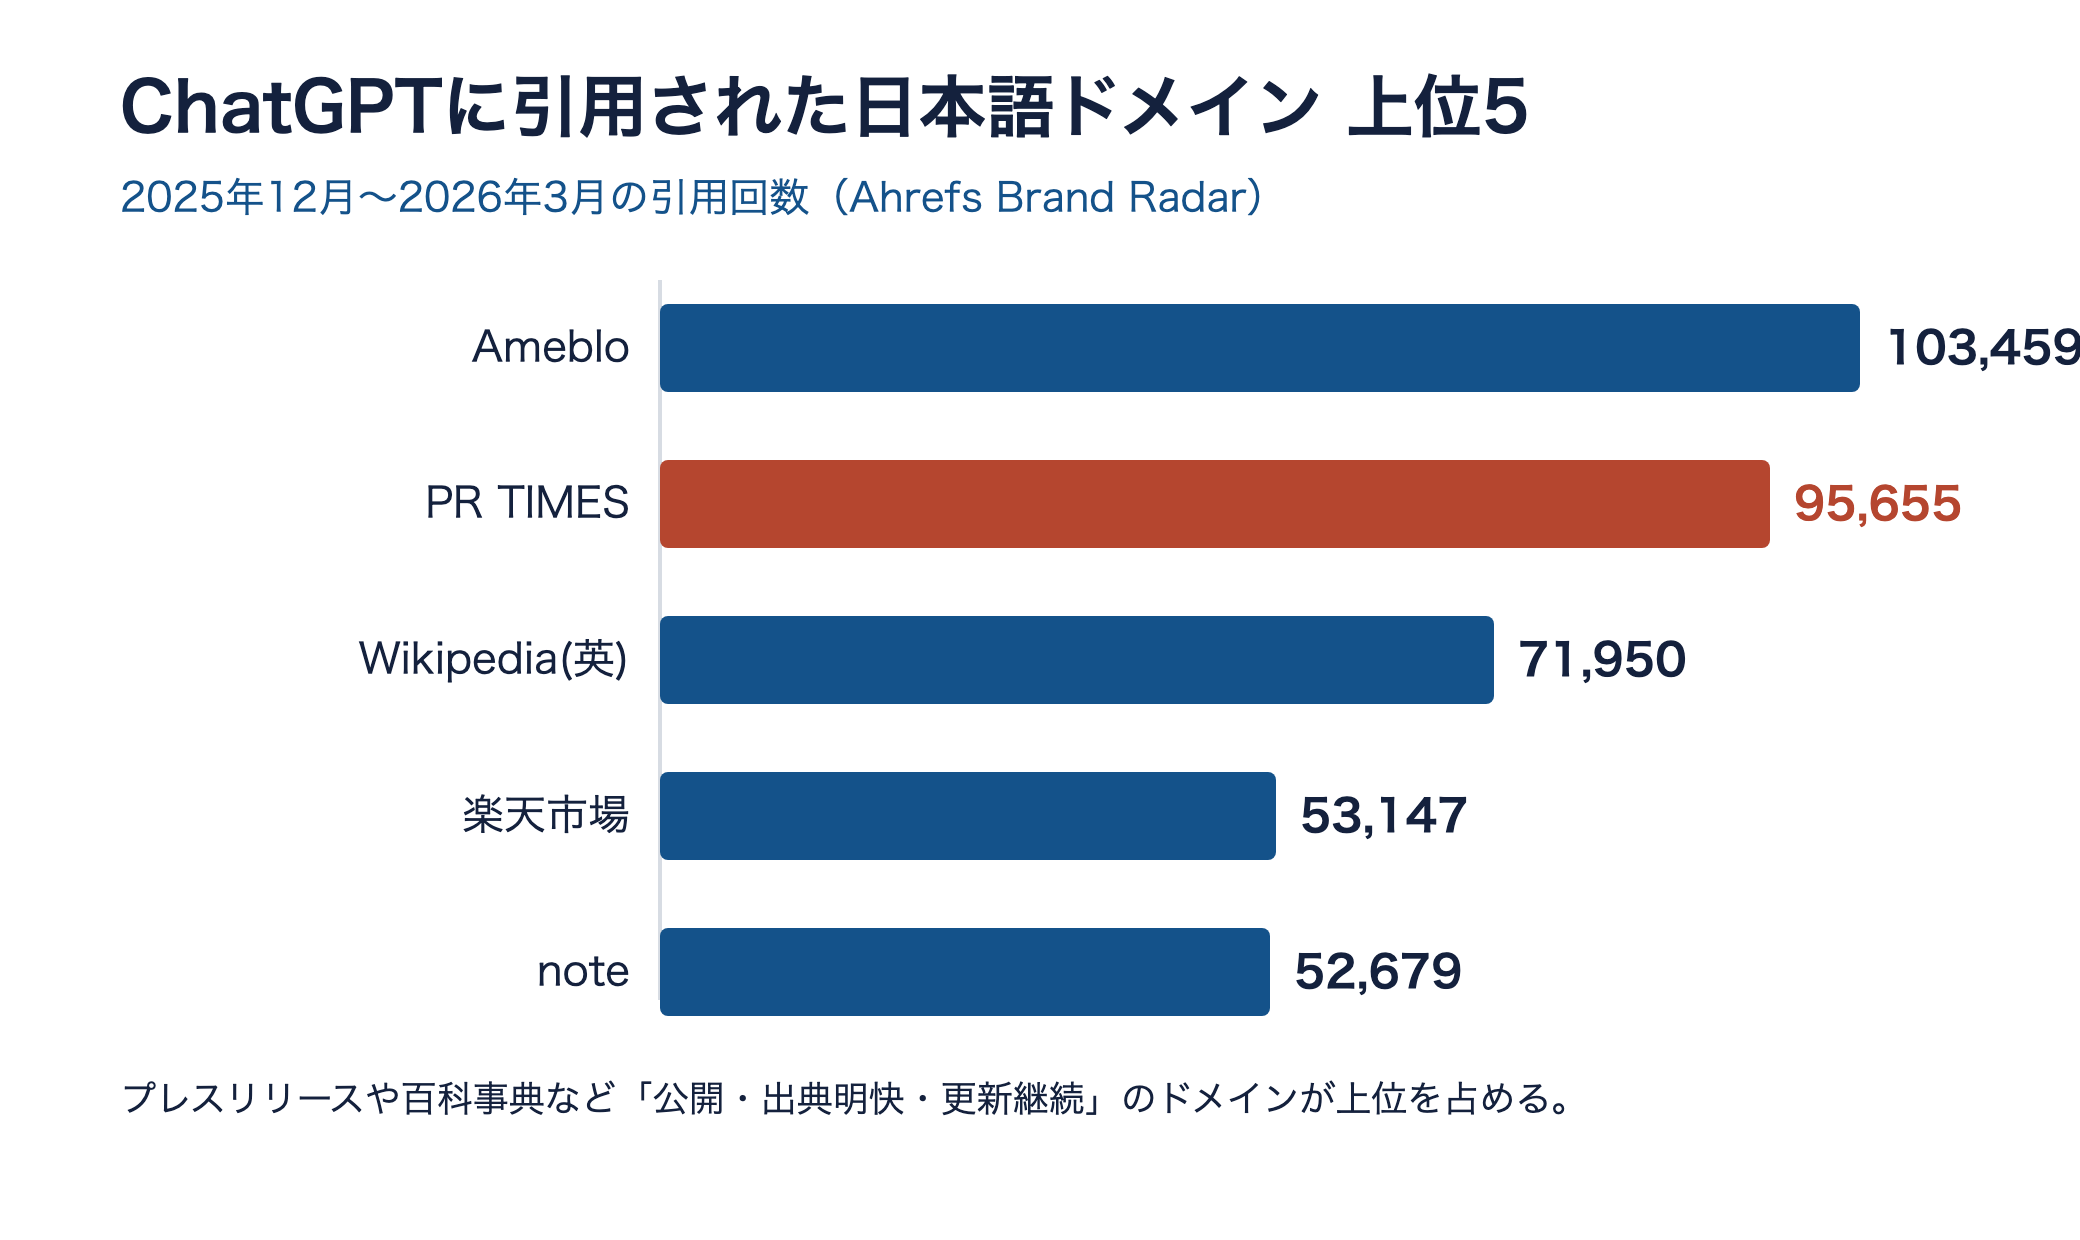
ChatGPTが日本語の質問に答えるとき、どのサイトを引用元に選んでいるのか。Ahrefsが自社ツールBrand Radarで2025年12月から2026年3月の引用を集計したところ、上位はアメブロ、PR TIMES、Wikipedia、楽天市場、noteという顔ぶれでした。個人の日記や一企業の広報が並ぶこの並びには、共通点があります。情報が公開されていて、要点が前段にまとまっていて、更新が止まっていない。つまり、機械が「何が書いてあるか」を取り出しやすいページが選ばれています。ここが出発点です。AIに引用されるかどうかは、文章の巧拙より前に、機械がその意味を正しく解釈できるかで大きく左右されます。
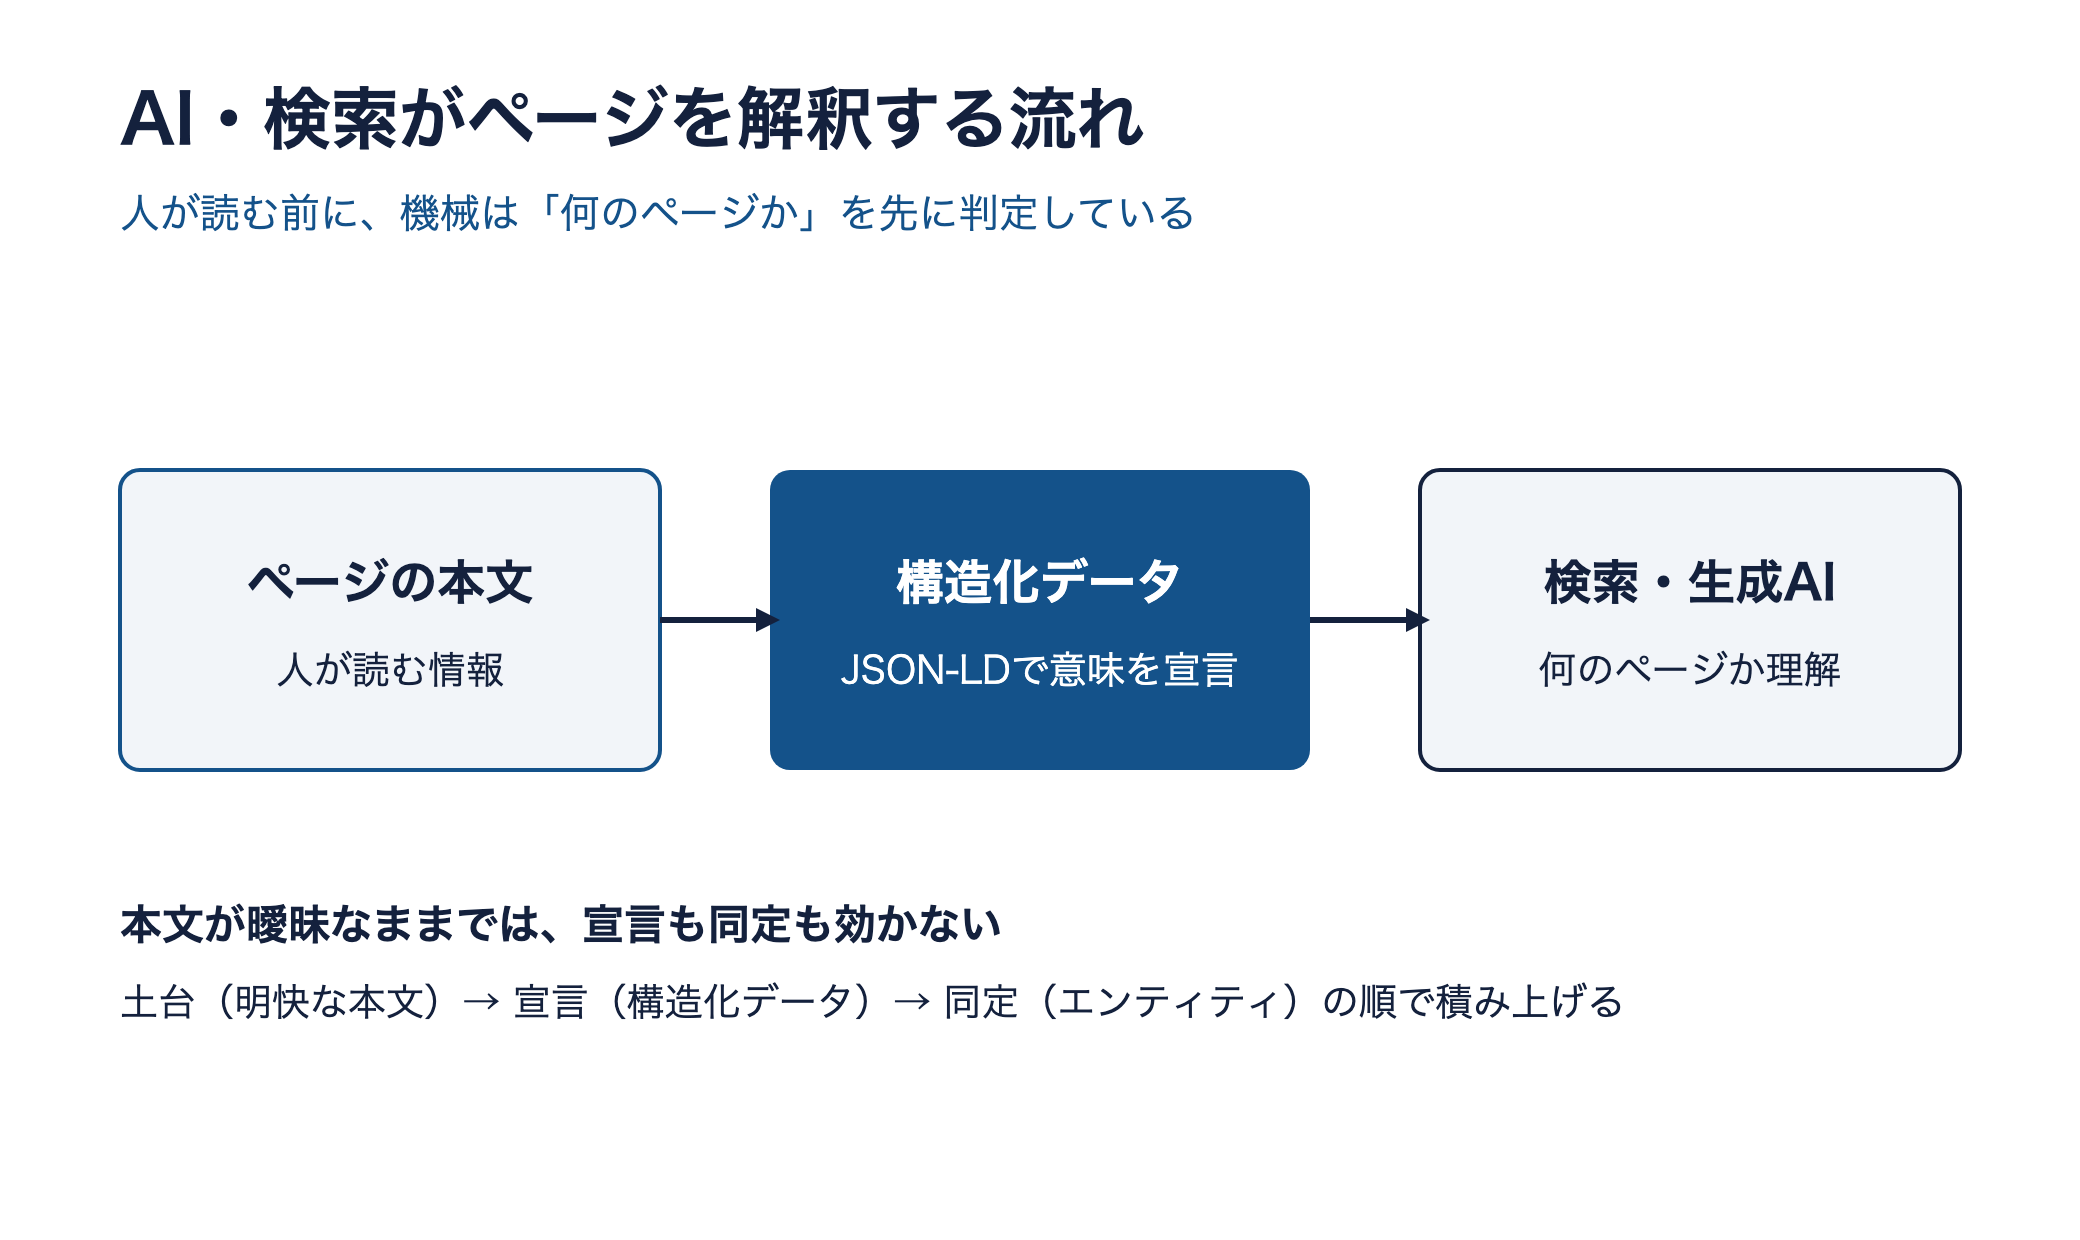
人間の読者は、多少わかりにくい文章でも文脈から意味を補って読みます。機械はそうはいきません。検索エンジンや生成AIは、ページを取り込んだ瞬間に「これは何についての、誰が書いた、どんな型の情報か」を機械的に判定しようとします。この判定の精度を上げる手がかりが構造化データです。schema.orgという共通の語彙を使って、ページの内容を「これは記事」「これは運営組織」「これはよくある質問」と明示的にラベル付けする。人が読む見た目は変えずに、機械向けの意味の層を1枚重ねるイメージです。以下では、その層をどう設計し、どう書き、どこで事故り、どう検証するかを、実装の順番どおりにたどります。
先に釘を刺す|構造化データは順位も引用も約束しない
実装の話に入る前に、避けて通れない前提を1つ。構造化データを入れれば上位に出る、AIに必ず引用される、という理解は誤りです。Googleは構造化データの一般ガイドラインで、正しくマークアップしてもリッチリザルトの表示は保証されず、どの機能を出すかはアルゴリズムが判断すると明記しています(Google 検索セントラル「構造化データの一般ガイドライン」)。構造化データは、機械にページの意味を伝わりやすくする土台であって、露出を切り替えるスイッチではありません。ここを取り違えると、マークアップを盛るほど成果が出るという発想になり、後述する「本文との不一致」という最もやってはいけない失敗に近づきます。土台を整えるという等身大の期待値で扱うのが、結局は近道です。では、土台を整えると実際に何が変わるのか。機械がページの型と主題を取り違えにくくなり、抜き出す情報の精度が上がります。これは引用の確率を高める方向には働きますが、確約ではありません。効果を保証しない代わりに、やってマイナスになりにくいのが構造化データの性質です。だからこそ、過度な期待でも食わず嫌いでもなく、当たり前の基礎工事として淡々と積む対象だと捉えるのが妥当です。
AI・検索が理解しやすい構造とは|明快な事実文・見出し階層・エンティティ
機械可読性という言葉は抽象的に聞こえますが、やることは3つに分けられます。1つ目は本文そのものを明快にすること。2つ目は見出しの階層で論理の骨格を伝えること。3つ目は誰の・何についての情報かを一意に示すこと。構造化データはこのうち主に2つ目と3つ目を担いますが、土台になるのは1つ目の本文です。本文が曖昧なままマークアップだけ足しても、機械が取り出す「中身」が薄いままなので、引用の候補になりにくい。順番を間違えないことが肝心です。
本文側の下ごしらえ|抜き出されやすい事実文の書き方
生成AIは、回答の材料として使えそうな一文をページから抜き出します。このとき抜き出しやすいのは、主語と述語がそろった短い言い切りです。「構造化データとは、schema.orgの語彙を使って、ページの内容を機械可読な形式で伝えるマークアップです」のように、定義を1文で完結させる。逆に、修飾を重ねて主語がどこかへ消えた長文や、「〜な場合もある」で終わる曖昧な文は、抜き出す単位を作れません。定義、数値、手順といった中核情報は、あちこちに散らさず1カ所にまとめる。段落の冒頭で結論を述べ、その後に根拠、最後に補足という順で書くと、機械も人も要点を先に受け取れます。PR TIMESが引用されやすい理由の1つが、リリース冒頭に要点を置く定型にあることを思い出すと、腑に落ちます。
具体例で差を見ます。避けたいのは「近年、生成AIの進化にともなって検索環境が大きく変わりつつあるなかで、構造化データの重要性についても改めて議論されるようになってきています」のような一文です。主語がぼやけ、結局何が言いたいのか機械には取り出せません。整えるなら「構造化データは、ページの内容を機械が理解できる形式で伝えるマークアップです。生成AIはこの情報を手がかりに、ページの主題を判定します」と、事実を2文に割って言い切る。前者から抜き出せる断片はありませんが、後者はそのまま回答の材料になります。1段落に主張を詰め込みすぎず、1つの事実を1つの文で完結させる。この地味な作業が、機械可読性のいちばん底を支えます。
もう一歩具体化すると、見出しの付け方も効きます。「概要」「ポイント」といった中身のない見出しではなく、「FAQPageのリッチリザルトは2023年に廃止された」のように、見出し自体が1つの事実を語る形にする。すると、その見出しの下に何が書いてあるかを機械が推測しやすくなります。h2、h3の階層も、装飾ではなく論理の入れ子として使う。大きな主題をh2に、その分解をh3に置くと、文書の構造が素直にたどれます。ここまでが構造化データを載せる前の下ごしらえで、ここが弱いと後工程がすべて空回りします。
構造化データで「何のページか」を宣言する|JSON-LDの基本
本文が整ったら、その意味を機械向けに宣言します。書き方の形式は複数ありますが、Googleが推奨するのはJSON-LDです。HTMLの本文とは分離してscriptタグの中に記述できるため、表示を崩さず、保守もしやすく、記述ミスが起きにくいという理由からです(Google 検索セントラル「構造化データの仕組み」)。語彙はschema.orgのものを使います。たとえば記事ページなら、typeにArticleを指定し、headlineに見出し、authorに著者、datePublishedに公開日を入れる。こうして「このページはArticleで、著者はこの人、公開日はこの日」と宣言すると、機械はページの型と属性を推測ではなく明示情報として受け取れます。
実装で迷ったときの原則は、公式が示しています。あらゆる推奨プロパティを不完全に埋めるより、少数でも完全で正確な必須プロパティを優先すること。そして、schema.orgとGoogleの記述が食い違う場合、Google検索での挙動についてはGoogle検索セントラルの記述を最終的な基準とすること。この2点を押さえておくと、プロパティを盛りすぎて破綻したり、schema.orgの一般論に引きずられて実際の検索挙動と噛み合わなくなったりする事故を避けられます。まずは自サイトで最も重要なページ1種類だけ、必須プロパティを正確に埋めるところから始めるのが現実的です。
記事ページのArticleを例に、最小構成をイメージで示します。宣言するのは、これはArticleであること、headlineとして記事の見出し、imageとして記事のメイン画像、authorとして著者の名前と種別、publisherとして運営組織、datePublishedとdateModifiedとして公開日と更新日、といった要素です。難しく考えず、ページを開いた読者が目にする情報を、そのまま機械向けに言い換えるだけと捉えると迷いません。見出しに出ていないタイトルをheadlineに書いたり、本文にいない著者をauthorに立てたりしないこと。表示されている情報と、宣言する情報を1対1でそろえる。これがArticleに限らず、あらゆる型に共通する書き方の芯になります。
引用されやすさに効く要素を分解する|本文・構造化データ・エンティティ
「構造化データを入れる」という一言は、実際には性質の違う3つの作業を含んでいます。ここを混ぜて考えると、本文が薄いのにマークアップだけ増やす、あるいは組織情報を宣言しないまま記事だけ飾る、といった片手落ちが起きます。3つの要素を、目的とやること、ありがちな失敗まで分解して並べます。自サイトのどこが手薄かを、この表で当てはめて確認できます。
| 要素 | 何のためか | 具体的にやること | よくある失敗 |
|---|---|---|---|
| 明快な事実文(本文) | AIが抜き出せる単位を用意する | 1文1事実、主語述語を省かない、定義や数値を1カ所に集約 | 修飾過多で主語が消え、抜き出す単位が作れない |
| 構造化データ(JSON-LD) | ページの意味を機械に宣言する | schema.orgの型で何のページかを宣言、必須プロパティを正確に | 本文にない情報までマークアップして不一致を起こす |
| エンティティの明示 | 誰の・何についての情報かを一意にする | Organizationやauthorを明記、sameAsで公式プロフィールに紐づけ | 固有名詞が曖昧で、別の同名主体と混同される |
3つ目のエンティティは見落とされがちなので補足します。エンティティとは、組織や人物、商品といった「一意に識別できる対象」のこと。同じ社名や人名は世の中にいくつも存在するため、ただ名前を書くだけでは機械はどの主体か確定できません。そこでOrganizationのsameApropertyに、公式サイトや各種プロフィールのURLを列挙して「この名前は、このネット上の実体と同一だ」と橋渡しします。記事のauthorにも、書き手の実在プロフィールを紐づける。こうしてE-E-A-Tの「誰が書いたか」を機械が追跡できる形にしておくと、発信主体の信頼性がAIにも伝わりやすくなります。本文で専門性を示し、構造化データで型を宣言し、エンティティで主体を同定する。この3層がそろって初めて、機械可読性は実用的な水準に届きます。
本文の明快化から構造化データ、エンティティ設計までを一度に整えるのは骨が折れます。激安AI SEOは、AI時代に読まれる記事設計と機械可読性の下ごしらえを、低コストの標準工程に組み込んでいます。
主要schemaタイプの使いどころ|サイト全体・記事・一問一答・事業情報
schema.orgには何百もの型がありますが、実務で最初に押さえるべきは限られます。ページ単位ではなく「何を伝えるための型か」で分類すると、選び方が見えてきます。サイト全体の素性を伝える型、コンテンツの型を伝える型、一問一答や手順を伝える型、事業や商品を伝える型の4系統です。自サイトのどのページに何を載せるかを、この整理から逆算します。
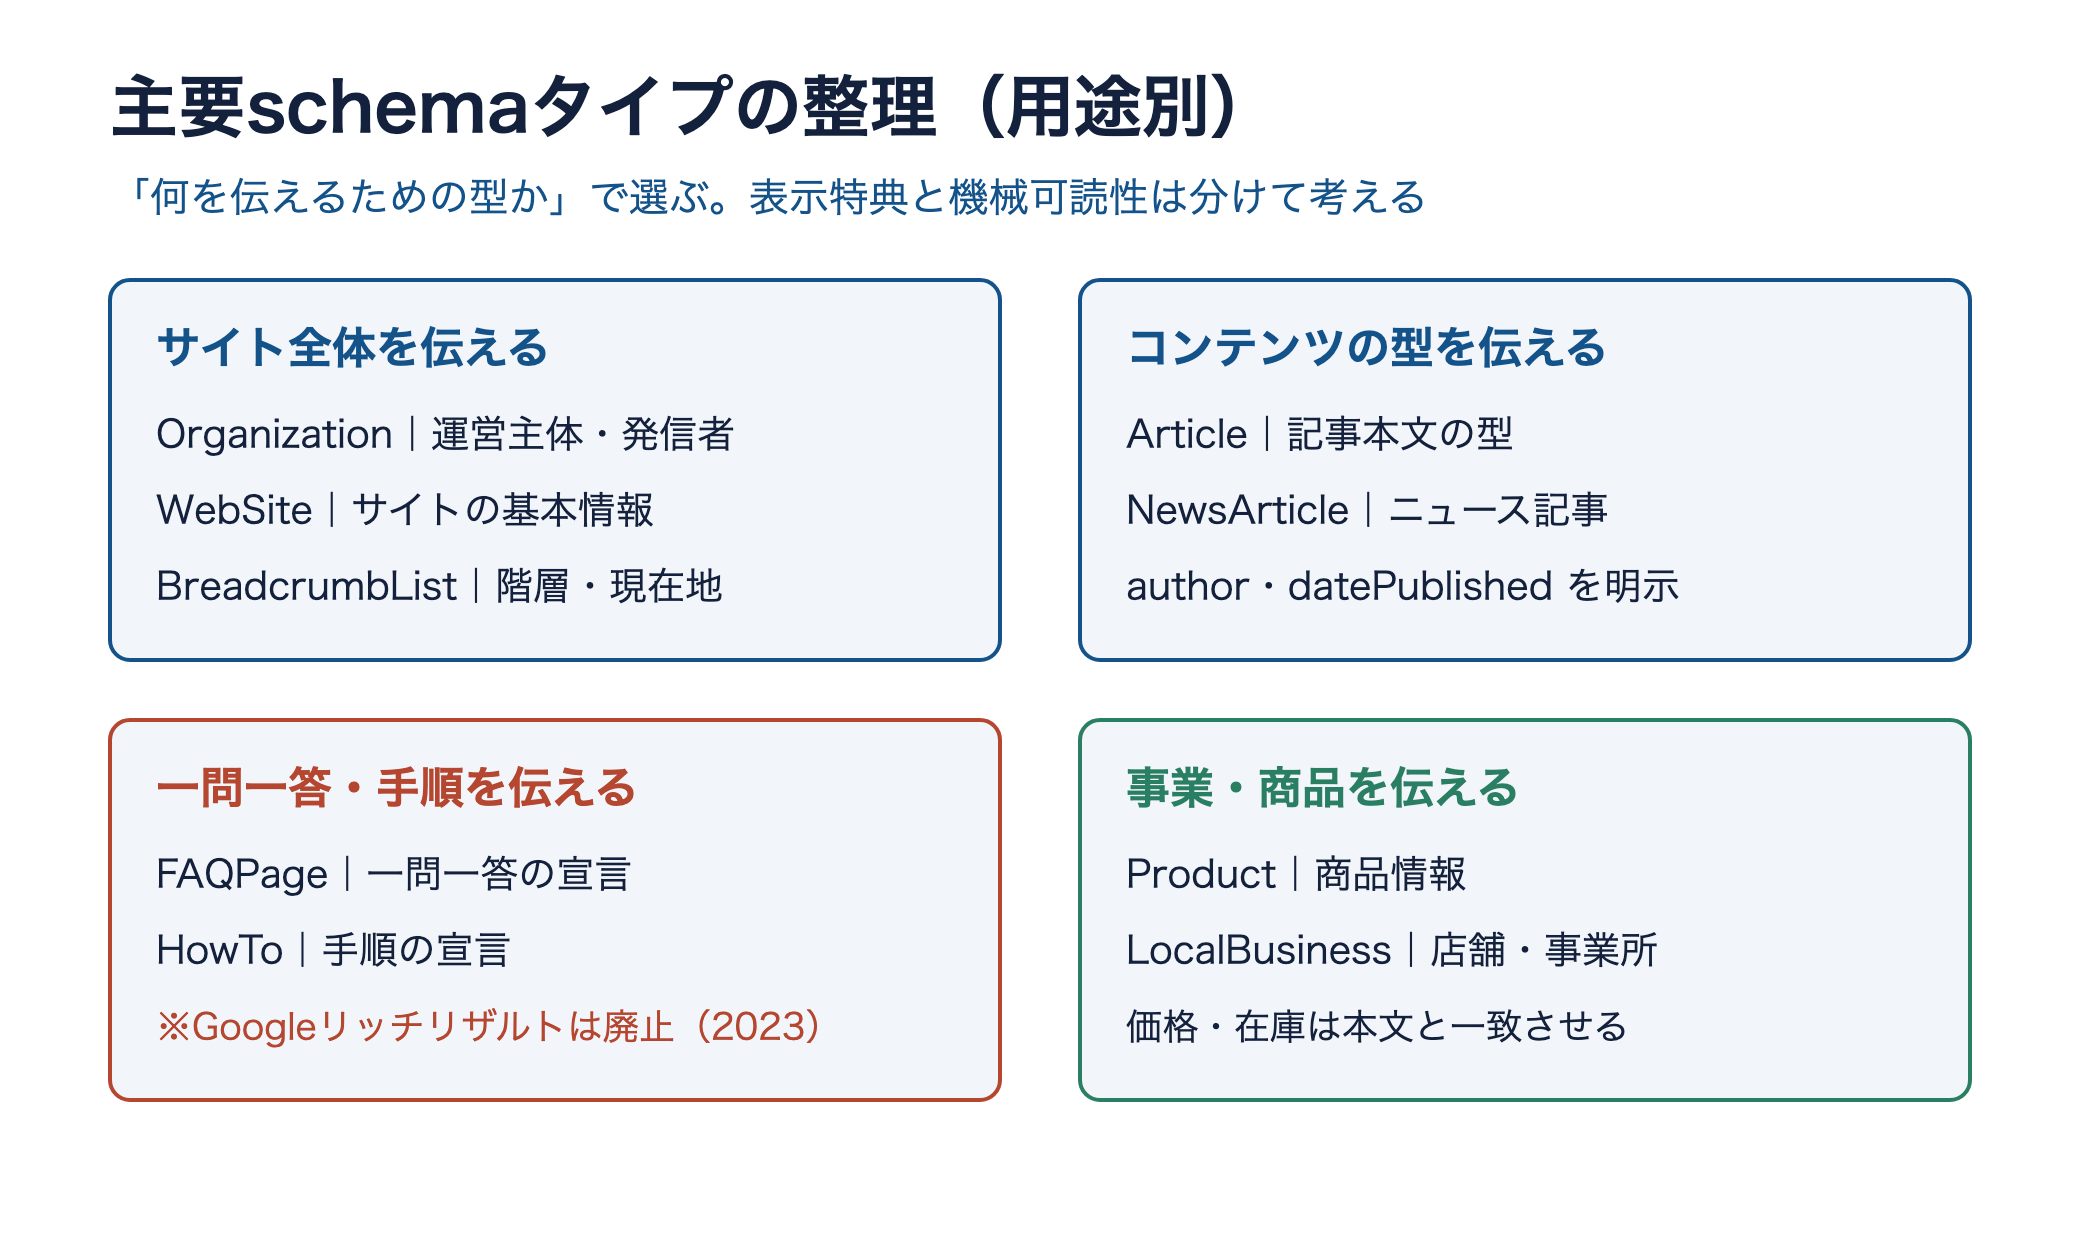
サイト全体を伝える型では、Organizationで運営主体を、WebSiteでサイトの基本情報を、BreadcrumbListで階層と現在地を宣言します。これらはトップページや共通テンプレートに置き、サイト全体の素性を機械に伝える役割です。コンテンツの型を伝えるのがArticleやNewsArticleで、記事ページに置いて著者や公開日を明示します。事業や商品を扱うサイトなら、ProductやLocalBusinessで価格や所在地を宣言する。どの型でも共通する原則は、宣言する属性を本文の実際の内容とそろえることです。
実装の優先順位に迷ったら、サイト全体を伝える型から入るのが定石です。OrganizationとWebSiteは一度整えれば全ページに効く共通基盤で、更新頻度も低い。ここで運営主体を明確にしておくと、個々の記事に載せるArticleのpublisherやauthorと組み合わさって、発信主体が一貫して機械に伝わります。BreadcrumbListは、サイトのどの位置にあるページかを機械に教える役割で、階層の深いサイトほど効きます。これらを土台に据えたうえで、集客の主力になっている記事ページへArticleを展開し、商品ページがあればProductを足す。全ページに一気に入れようとせず、効果の波及範囲が広い型から順に固めると、実装も検証も管理しやすくなります。ここから、扱いに注意が要る2つの型を個別に見ます。
FAQPage・HowToの扱い|リッチリザルト廃止後も機械可読性には残る
FAQPageとHowToは、AIに引用されたい人が真っ先に飛びつきやすい型です。一問一答も手順も、質問と回答、工程と説明という対構造を持つため、機械が抜き出しやすい形をしています。ただし1つ、重要な仕様変更を知らずに推奨している記事が少なくありません。GoogleはFAQのリッチリザルトを2023年に大幅縮小し、現在は検索結果での表示を終了しています(Google 検索セントラル「FAQ(よくある質問)の構造化データ」)。HowToのリッチリザルトも同じ2023年に、デスクトップとモバイルの双方で表示を終了しました(Google 検索セントラル「HowTo(ハウツー)の構造化データ」)。
ここで誤解したくないのは、「表示が消えた=マークアップが無意味になった」ではないという点です。リッチリザルトという検索結果上の見た目の特典はなくなりました。一方で、そのページが一問一答であり、手順であるという意味の宣言そのものは、機械がページを解釈する手がかりとして残ります。だからFAQPageやHowToを使うなら、検索結果を飾る目的ではなく、本文の構造を正直に宣言する目的で使う。実際に本文にQ&Aや手順が書かれていて、その内容と一致しているなら、宣言する価値はあります。逆に、表示特典目当てで、本文にないQ&Aを構造化データだけで作るのは、次章で述べる不一致の典型で、リスクにしかなりません。
使い分けの目安を1つ挙げます。ページに本物のよくある質問が数件あり、それぞれ簡潔な回答が本文に書かれているなら、FAQPageで宣言する価値はあります。手順を追う解説記事で、工程が番号付きで並んでいるなら、HowToも同様です。一方、リッチリザルトの表示だけが狙いだったなら、その目的はもう果たせないので、無理に付ける必要はありません。判断の軸は常に、検索結果の見た目ではなく、本文の構造を正直に機械へ伝えられるかどうか。この基準で選べば、仕様変更に振り回されずに済みます。
実装で最も事故る一点|マークアップと表示内容の一致は必須
構造化データの実装で、技術的な書き方以上に事故が多いのがここです。原則は単純で、ユーザーに見えない情報をマークアップしてはいけない、という一文に尽きます。Googleは構造化データの入門ドキュメントで、情報が正確であってもユーザーに見えないならマークアップしてはならないと明記し、空のページを構造化データのためだけに作ることも禁じています(Google 検索セントラル「構造化データの仕組み」)。星のない商品に高評価をマークアップする、本文にない手順を宣言する、といった水増しは、この禁止に真正面から触れます。よくある具体例を挙げると、実際には掲載していないレビューの星評価をProductに付ける、本文では触れていない割引価格をofferに書く、記事内に存在しないQ&AをFAQPageで宣言する、といったものです。どれも「表示を良く見せたい」という同じ動機から生まれ、同じ結果を招きます。
一致を守らないコストは軽くありません。Googleの一般ガイドラインは、本文と関連しない、あるいは誤解を招くマークアップを禁止し、違反した場合は手動対策の対象になりうると示しています。手動対策を受けると、そのページはリッチリザルトの対象から外れます。表示を良く見せたい一心で盛ったマークアップが、かえって機会を失わせる。この因果は、生成AIに引用されたい局面でも同じ方向に働きます。AIも検索エンジンも、本文と宣言の食い違いを、信頼できない発信元のサインとして扱う方向にあります。だからこそ、実装の最終チェックは常に「この宣言は、本文に実際に書いてあるか」に戻ります。マークアップは本文の後追いであって、本文を先回りしてはいけません。
本文と構造化データの一致を1ページずつ点検するのは手間がかかります。激安AI SEOは、本文の作成とマークアップ設計を同じ工程で回し、表示と宣言のズレを起こしにくい形で納品します。
実装したら必ず検証する|リッチリザルトテストとバリデータの使い分け
構造化データは、書いて公開して終わりではありません。JSON-LDは本文と分離しているぶん、記述ミスが見た目に現れず、気づかないまま放置されがちです。だから公開の前後で必ず検証します。使うツールは主に3つで、役割が違います。まずリッチリザルトテストは、Googleがそのページをリッチリザルトの対象として認識するか、構文エラーがないかを確認できます。次にschema.orgのスキーママークアップバリデータは、型やプロパティの書式がschema.org準拠かをチェックします。この2つは公開前の点検向きです。3つ目のSearch Consoleの拡張レポートは、公開後に実サイトでどれだけ検出され、どんなエラーが出ているかを継続監視するのに使います。
検証の順番も決めておくと迷いません。ローカルやステージングで書いたら、まずバリデータで構文を確かめる。次にリッチリザルトテストで、Googleが意図した型として読めているかを見る。公開後はSearch Consoleで、検出数の推移とエラー通知を定期的に確認する。エラーが出たら、多くは必須プロパティの欠落か、値の書式ミスか、本文との不一致のいずれかです。特に不一致は、ツールが構文上は通してしまうため、人の目で「宣言と本文がそろっているか」を最後に照合する工程を残しておくのが安全です。この検証の習慣が、手動対策のような後戻りしにくい事故を未然に防ぎます。
Search Consoleのレポートを読むときは、「検出された」と「有効」の違いに注意します。検出されただけでは、Googleが構造を認識したにとどまり、エラーや警告を抱えたまま有効になっていないことがあります。エラーは必須プロパティの欠落など致命的なもの、警告は推奨プロパティの不足など任意のものが多く、まずエラーの解消を優先します。テンプレートを直せば同種のページのエラーが一括で消えることが多いので、1ページの修正を型として全体へ反映すると効率的です。公開後にページの仕様を変えたときは、構造化データも一緒に更新されているかを確認する。CMSやプラグインが自動生成している場合は、テーマの更新や設定変更でマークアップが変わることがあるため、大きな更新のあとに再検証する習慣をつけておくと安全です。
構造化データはAI任せの免罪符ではない|品質と一次情報が前提
ここまで実装と検証を細かく見てきましたが、構造化データはあくまで土台です。土台の上に載る中身が薄ければ、機械可読性を上げても引用にはつながりません。Semrushが検索順位とコンテンツの生成手段を調べた調査では、検索1位のページは人間が書いたものが80.5%を占め、AI生成は約10%にとどまりました(Semrush「Does AI Content Rank?」調査)。Google自身も、コンテンツを制作手段で判断するのではなく、独自性と有用性という品質で評価すると公式に示しています(Google 検索セントラル「AI生成コンテンツに関するガイダンス」)。構造化データで型を整えても、中身がどこかで見た焼き直しなら、機械はそれを見抜きます。
生成AIの業務活用そのものは広がっています。総務省の令和7年版情報通信白書によれば、生成AIの活用方針を定めている企業は49.7%と、前年の42.7%から伸びました(総務省 令和7年版情報通信白書)。普及が進むほど、AIで量産した似た記事が増え、その中で抜きん出るには一次情報と専門性が要ります。SEO支援のLANYも、AIを使う場合でも人手によるE-E-A-Tの付与とファクトチェックが欠かせないと整理しています(LANY「AI SEO」)。構造化データは、その良質な中身を機械に正しく伝えるための翻訳装置であって、中身の代わりにはなりません。
実装の第一歩は小さくてかまいません。自サイトで最も重要なページを1つ選び、本文を1文1事実に整え、ArticleかOrganizationのどちらか1つを必須プロパティだけ正確にマークアップする。書いたらリッチリザルトテストとバリデータで構文を確かめ、宣言と本文が一致しているかを目視で照合する。この1ページを型として、他のページへ横展開していく。順番さえ守れば、構造化データはAIに引用される確率を高める堅実な土台になります。
激安AI SEOは、一次情報と人手のファクトチェックを前提に、本文設計から構造化データの実装・検証までを低コストで一気通貫にします。AI時代に引用される土台づくりを、まず無料で相談できます。